> ## Documentation Index
> Fetch the complete documentation index at: https://platform.kimi.com/docs/llms.txt
> Use this file to discover all available pages before exploring further.
# 使用 Kimi API 的上下文缓存功能
> 了解 Kimi API 上下文缓存的适用场景与计费,提高缓存命中率,选择和设置 TTL,并查看缓存用量。
上下文缓存让服务端复用你的相同请求前缀。前缀指请求 messages 中从开头连续的 token 序列;缓存按最长匹配前缀计算,匹配成功即为命中。命中部分按缓存命中价格计费,命中越多,越节省成本。以 `kimi-k3` 为例,缓存命中价格仅为未命中价格的 **1/10**。本页介绍如何提高缓存命中率、选择和设置 TTL(Time To Live,缓存时长),并通过 `usage` 字段验证缓存效果。
## 哪些内容适合缓存
上下文缓存适合在多次请求中重复发送固定内容的场景,例如:
| 场景 | 反复发送的固定内容 |
| --------- | ----------------------- |
| 文档问答 | 产品文档、知识库或公司制度 |
| 编程 Agent | 代码库、开发规范和工具定义 |
| 长会话 Agent | system prompt、工具定义和会话规则 |
| 定时巡检与报告 | 报告模板、指标定义和参考资料 |
命中缓存后,重复部分按缓存命中价格计费。如果相同前缀很少复用,或复用间隔超过 TTL,使用上下文缓存的收益有限,不必专门配置。
## 上下文缓存能省多少钱
Cache Write(缓存写入)现在单独列为计费项。以 `kimi-k3` 为例,缓存相关价格如下:
| 计费项 | 价格(每 1M tokens) | 说明 |
| ------------------ | --------------- | --------------------------------------------- |
| Input(缓存未命中) | ¥20 | 请求中未命中缓存的部分(每次请求单独计费) |
| Cache Write(`5m`) | ¥20 | 前缀首次写入缓存时一次性收取;写入后 5 分钟内有效,每次命中后有效期重新计算为 5 分钟 |
| Cache Write(`1h`) | ¥40 | 前缀首次写入缓存时一次性收取;写入后 1 小时内有效,每次命中后有效期重新计算为 1 小时 |
| Cached Input(缓存命中) | ¥2 | 请求中命中缓存的部分(每次请求单独计费) |
其他模型与计费项的完整价格,见[模型推理价格说明](/docs/pricing/chat)。
费用可以总结为两点:
* **总价不变**:缓存写入的拆分是计费透明化,不是涨价。写入成本原先就包含在输入价格中,拆分后现有请求的整体费用不变。
* **命中就省钱**:缓存命中价格是缓存未命中价格的 1/10。以 `kimi-k3` 为例,命中部分按缓存命中价格计费(¥2 / 1M tokens),每次命中比缓存未命中少 ¥18 / 1M tokens。
以 `1h` 为例算一笔账(假设前缀 1M tokens),只要在 1 小时内再命中 2 次,就比选 `5m` 划算;命中越多省得越多。
* 选 `1h` 而不是 `5m`,唯一多付的成本是写入费贵 ¥20(¥40 vs ¥20)。
* 之后每命中一次缓存,这部分输入的成本从 ¥20 降到 ¥2,省 ¥18。
* 所以:命中 1 次,省 ¥18;命中 2 次,共省 ¥36,扣掉多付的 ¥20,选择 `1h` 比选择 `5m` 净省 ¥16。
## 提高缓存命中率
缓存按请求前缀匹配。前缀中任何一处发生变化,该位置之后的内容都无法复用,因此建议:
1. 把稳定的 system prompt、工具定义、参考资料和代码库放在请求前部。
2. 把用户问题、工具结果和任务状态等每轮变化的内容放在后部。
3. 保持同一会话中固定内容的顺序和文本完全一致,不要在前缀中插入时间戳、随机 ID 或其他动态字段。
4. 将定时任务的执行间隔控制在 TTL 内,利用命中续期保持缓存有效。
5. 缓存按组织(org)隔离:同一组织内共享,组织之间不共享。
缓存不支持手动清除;缓存前缀无活动超过所选 TTL 后自动过期。
## 选择合适的 TTL
缓存写入支持 `5m` 和 `1h` 两档 TTL。不传 `prompt_cache_options` 时,系统默认使用 `5m` TTL:满足命中条件的前缀会自动写入并尝试复用,账单上会产生相应的缓存写入费用。
* 连续追问间隔通常不超过 5 分钟时,选择 `5m`。
* 请求间隔会超过 5 分钟、但能在 1 小时内复用时,选择 `1h`;命中 2 次即可覆盖多付的写入费用(算账见「上下文缓存能省多少钱」一节)。
* 相同前缀通常要间隔超过 1 小时才会复用时,不建议专门配置缓存。
缓存条目的 TTL 在首次写入时锁定,不能改写:相同前缀命中后按原 TTL 免费续期,新增部分也按锁定的 TTL 继续写入。已有条目完全过期后,才能用新的 TTL 重新写入。
## 如何设置缓存 TTL
Chat Completions API 和 Responses API 在省略 `prompt_cache_options` 时默认按 `5m` TTL 写入缓存。需要指定 TTL 时,传入 `prompt_cache_options`:
```bash theme={null}
# 将 prompt_cache_options.ttl 设置为 "5m" 或 "1h"。
curl https://api.moonshot.cn/v1/chat/completions \
--header "Content-Type: application/json" \
--header "Authorization: Bearer $MOONSHOT_API_KEY" \
--data '{
"model": "kimi-k3",
"messages": [
{"role": "system", "content": "你是一个产品文档问答助手。\n\n产品文档:……"},
{"role": "user", "content": "这个产品支持哪些认证方式?"}
],
"prompt_cache_options": {"mode": "implicit", "ttl": "1h"}
}'
```
`prompt_cache_options.mode` 当前仅支持 `implicit`,`ttl` 支持 `5m` 和 `1h`。Responses API 使用相同的参数,详见 [Responses API](/docs/api/responses)。
Anthropic Messages API 使用顶层 `cache_control` 控制缓存写入。传入该字段时,请求前缀会按指定 TTL 写入缓存;省略该字段时,本次请求只读取 `5m` 缓存,不写入缓存:
```bash theme={null}
# 将 cache_control.ttl 设置为 "5m" 或 "1h"。
curl https://api.moonshot.cn/anthropic/v1/messages \
--header "Content-Type: application/json" \
--header "Authorization: Bearer $MOONSHOT_API_KEY" \
--data '{
"model": "kimi-k3",
"cache_control": {"type": "ephemeral", "ttl": "1h"},
"max_tokens": 256,
"messages": [{"role": "user", "content": "你好"}]
}'
```
`cache_control` 只在请求顶层生效,消息体内的同名标记会被忽略。完整参数说明见 [Messages API](/docs/api/messages)。
现有请求无需改造。缓存写入拆分后,账单会新增缓存写入明细。
## 查看缓存读写用量
不同 API 使用不同的 `usage` 字段记录缓存读写情况。依赖 `usage` 字段统计成本的应用,请按下表迁移字段:
| API | 总输入 | 缓存读取 | 缓存写入 |
| ---------------- | ---------------------------------------------------------------------------------------- | ------------------------------------------- | ------------------------------------------------ |
| Chat Completions | `usage.prompt_tokens` | `usage.prompt_tokens_details.cached_tokens` | `usage.prompt_tokens_details.cache_write_tokens` |
| Responses | `usage.input_tokens` | `usage.input_tokens_details.cached_tokens` | `usage.input_tokens_details.cache_write_tokens` |
| Messages | `usage.input_tokens + usage.cache_read_input_tokens + usage.cache_creation_input_tokens` | `usage.cache_read_input_tokens` | `usage.cache_creation_input_tokens` |
对于 Chat Completions API 和 Responses API,缓存读取、缓存写入和未缓存部分互斥,三者之和等于总输入 Token 数。Messages 的 `usage.input_tokens` 不包含缓存读取和写入部分;其中 `usage.cache_creation.ephemeral_5m_input_tokens` 和 `usage.cache_creation.ephemeral_1h_input_tokens` 分别记录两个 TTL 下的写入 Token 数。
使用 Chat Completions API 的流式请求时,需要设置 `stream_options.include_usage=true`,完整的缓存读写明细才会出现在最后一个 chunk 的 `usage` 字段中。
## 常见问题
`kimi-k3` 支持 Cache Write;`kimi-k2.7`、`kimi-k2.7-highspeed`、`kimi-k2.6` 不支持。
相同 TTL 的相同前缀命中缓存后:
* 命中部分不再收取 Cache Write 费用,仅按 Cached Input(缓存命中)价格计费,以 `kimi-k3` 为例约为缓存未命中价格的 1/10;
* 缓存在有效期内被命中会自动按原 TTL 免费续期,续期不单独收费。
例如:首次请求写入 `1h` 缓存并支付一次写入费用;30 分钟后再请求且命中,缓存从该时间点自动续期 1 小时,后续请求只按缓存命中价格计费。
关键看请求间隔:
* 请求间隔稳定小于 5 分钟(如连续调用的 Agent 任务):默认 `5m` 档即可,命中会免费续期,无需选择 `1h`;
* 请求间隔可能超过 5 分钟(长会话、有人工介入的任务):选择 `1h` 档可以避免缓存过期后重复写入,显著降低成本,同时缩短首 token 延迟(TTFT)。
按定价,`1h` 写入命中 2 次即可覆盖多付的写入费用,命中越多省得越多(算账见上文「上下文缓存能省多少钱」);详细选型建议见「选择合适的 TTL」。
`5m` 与 `1h` 是两个缓存不互通;缓存按组织(org)隔离,同一组织内共享,组织之间不共享。缓存不支持手动清除,无活动超过所选 TTL 后自动过期,例如 `5m` 档缓存至少 5 分钟无活动后过期。
不可以。缓存条目的 TTL 在首次写入时锁定,有效期内反复命中也只按原 TTL 免费续期。如需切换 TTL,等该条目完全过期后,再按新 TTL 重新写入。
缓存按块存储,不足一整块的部分无法写入缓存,会计为缓存未命中,按缓存未命中(Input)价格计费。
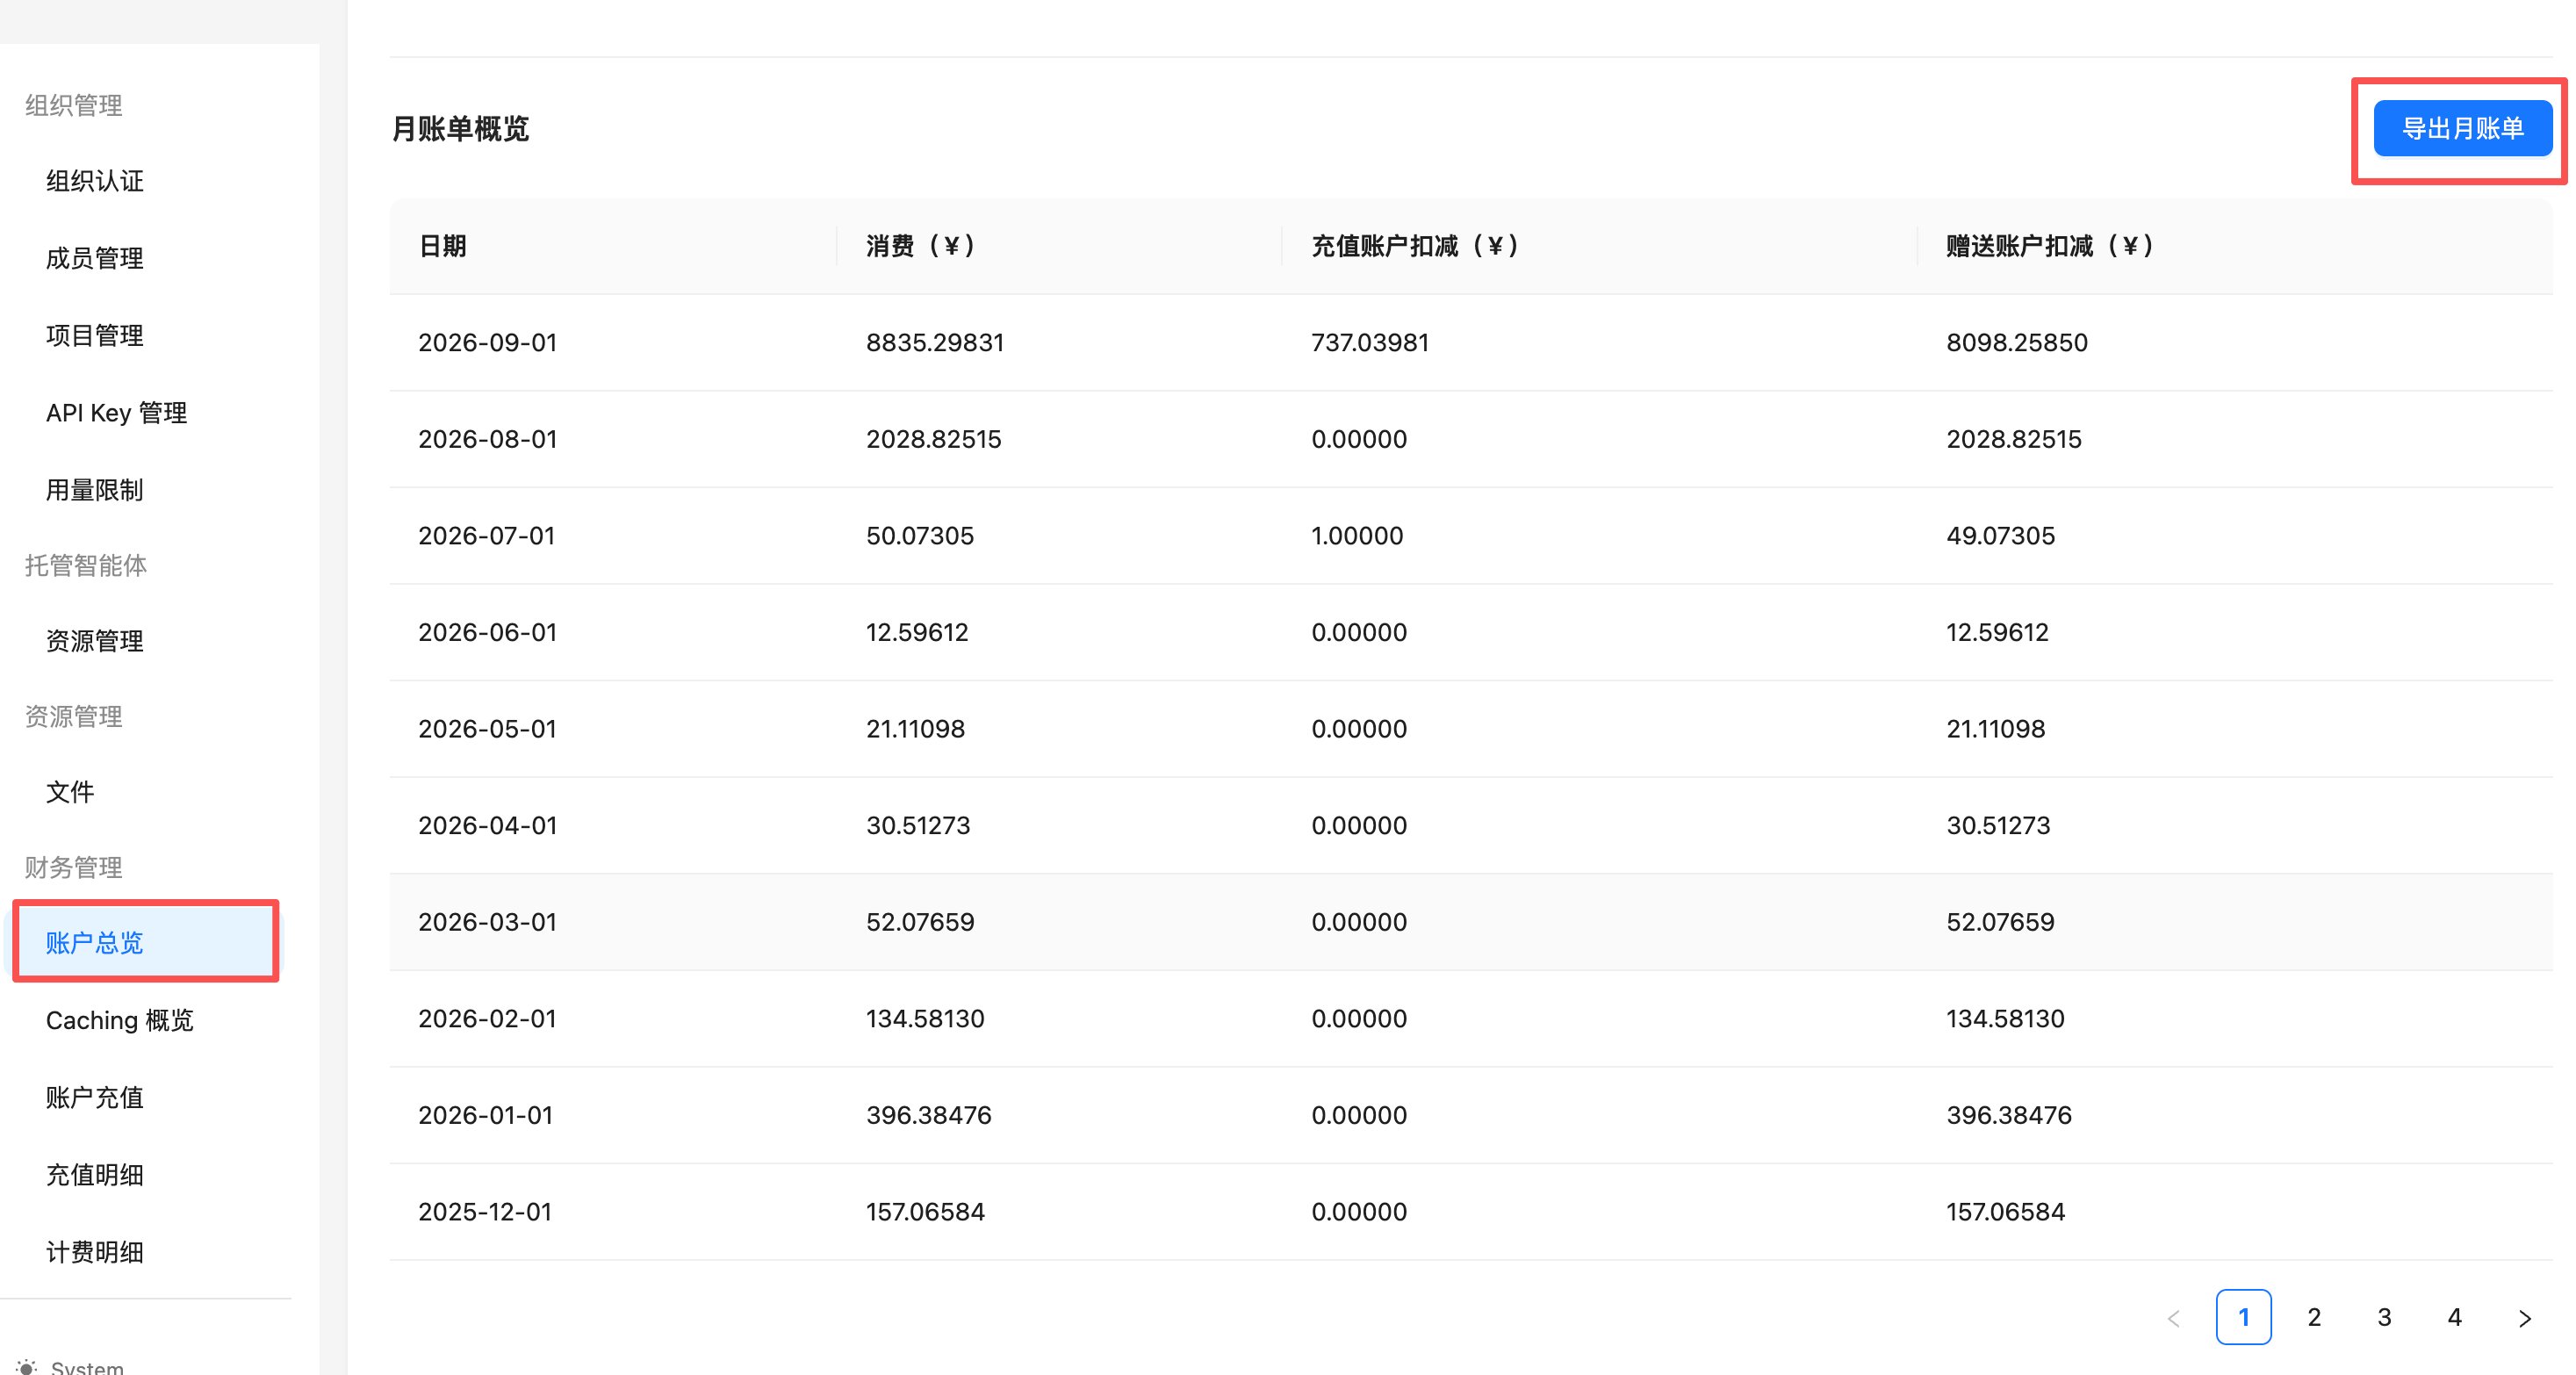
* 控制台「财务管理 → 账户总览」页面底部的「月账单概览」支持导出每月账单 Excel,导出的表格新增「账单明细-缓存写入」sheet,按天展示 `5m` / `1h` 各自的写入费用,以及项目、组织、API Key 等维度:
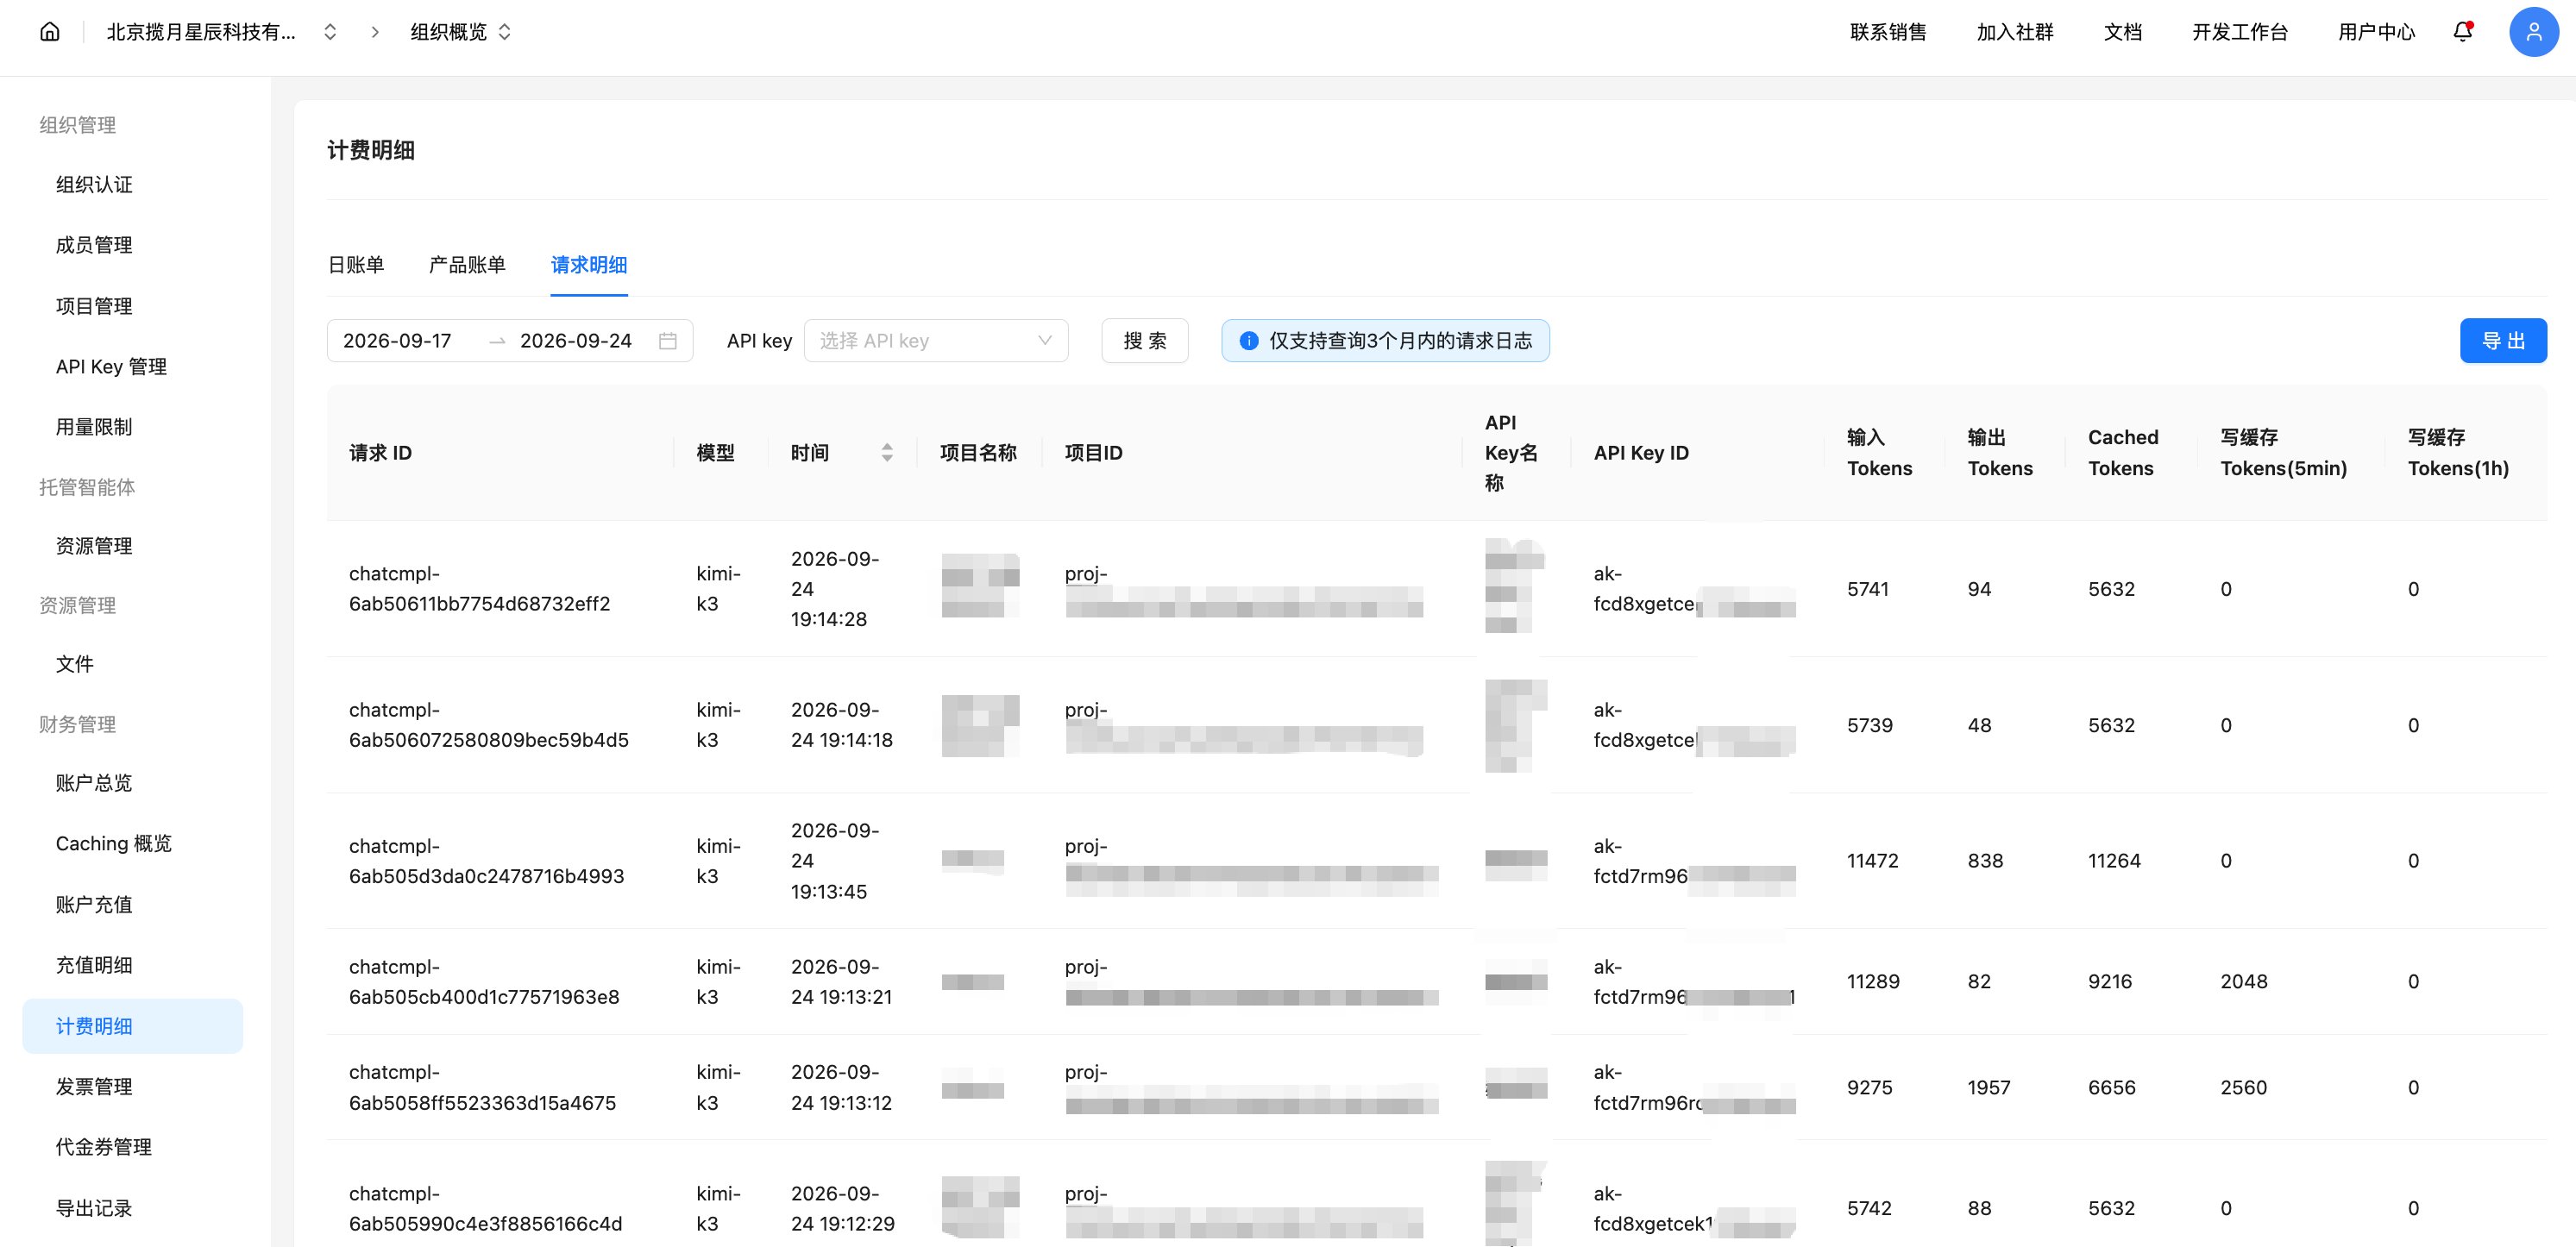
 * 控制台「计费明细 → 请求明细」新增「写缓存 Tokens(5min)」和「写缓存 Tokens(1h)」两列,方便对账;输入 tokens = 缓存未命中 tokens + 缓存命中 tokens + 缓存写入 tokens:
 以 Chat Completions API 为例,如需在代码中区分本次写入的 TTL 档位,可读取响应 Header:
* `Msh-Usage-Cache-Write-Tokens-5m`:本次按 `5m` 档写入的 token 数;
* `Msh-Usage-Cache-Write-Tokens-1h`:本次按 `1h` 档写入的 token 数。
本次请求全部命中、没有新增写入时,对应值为 0。
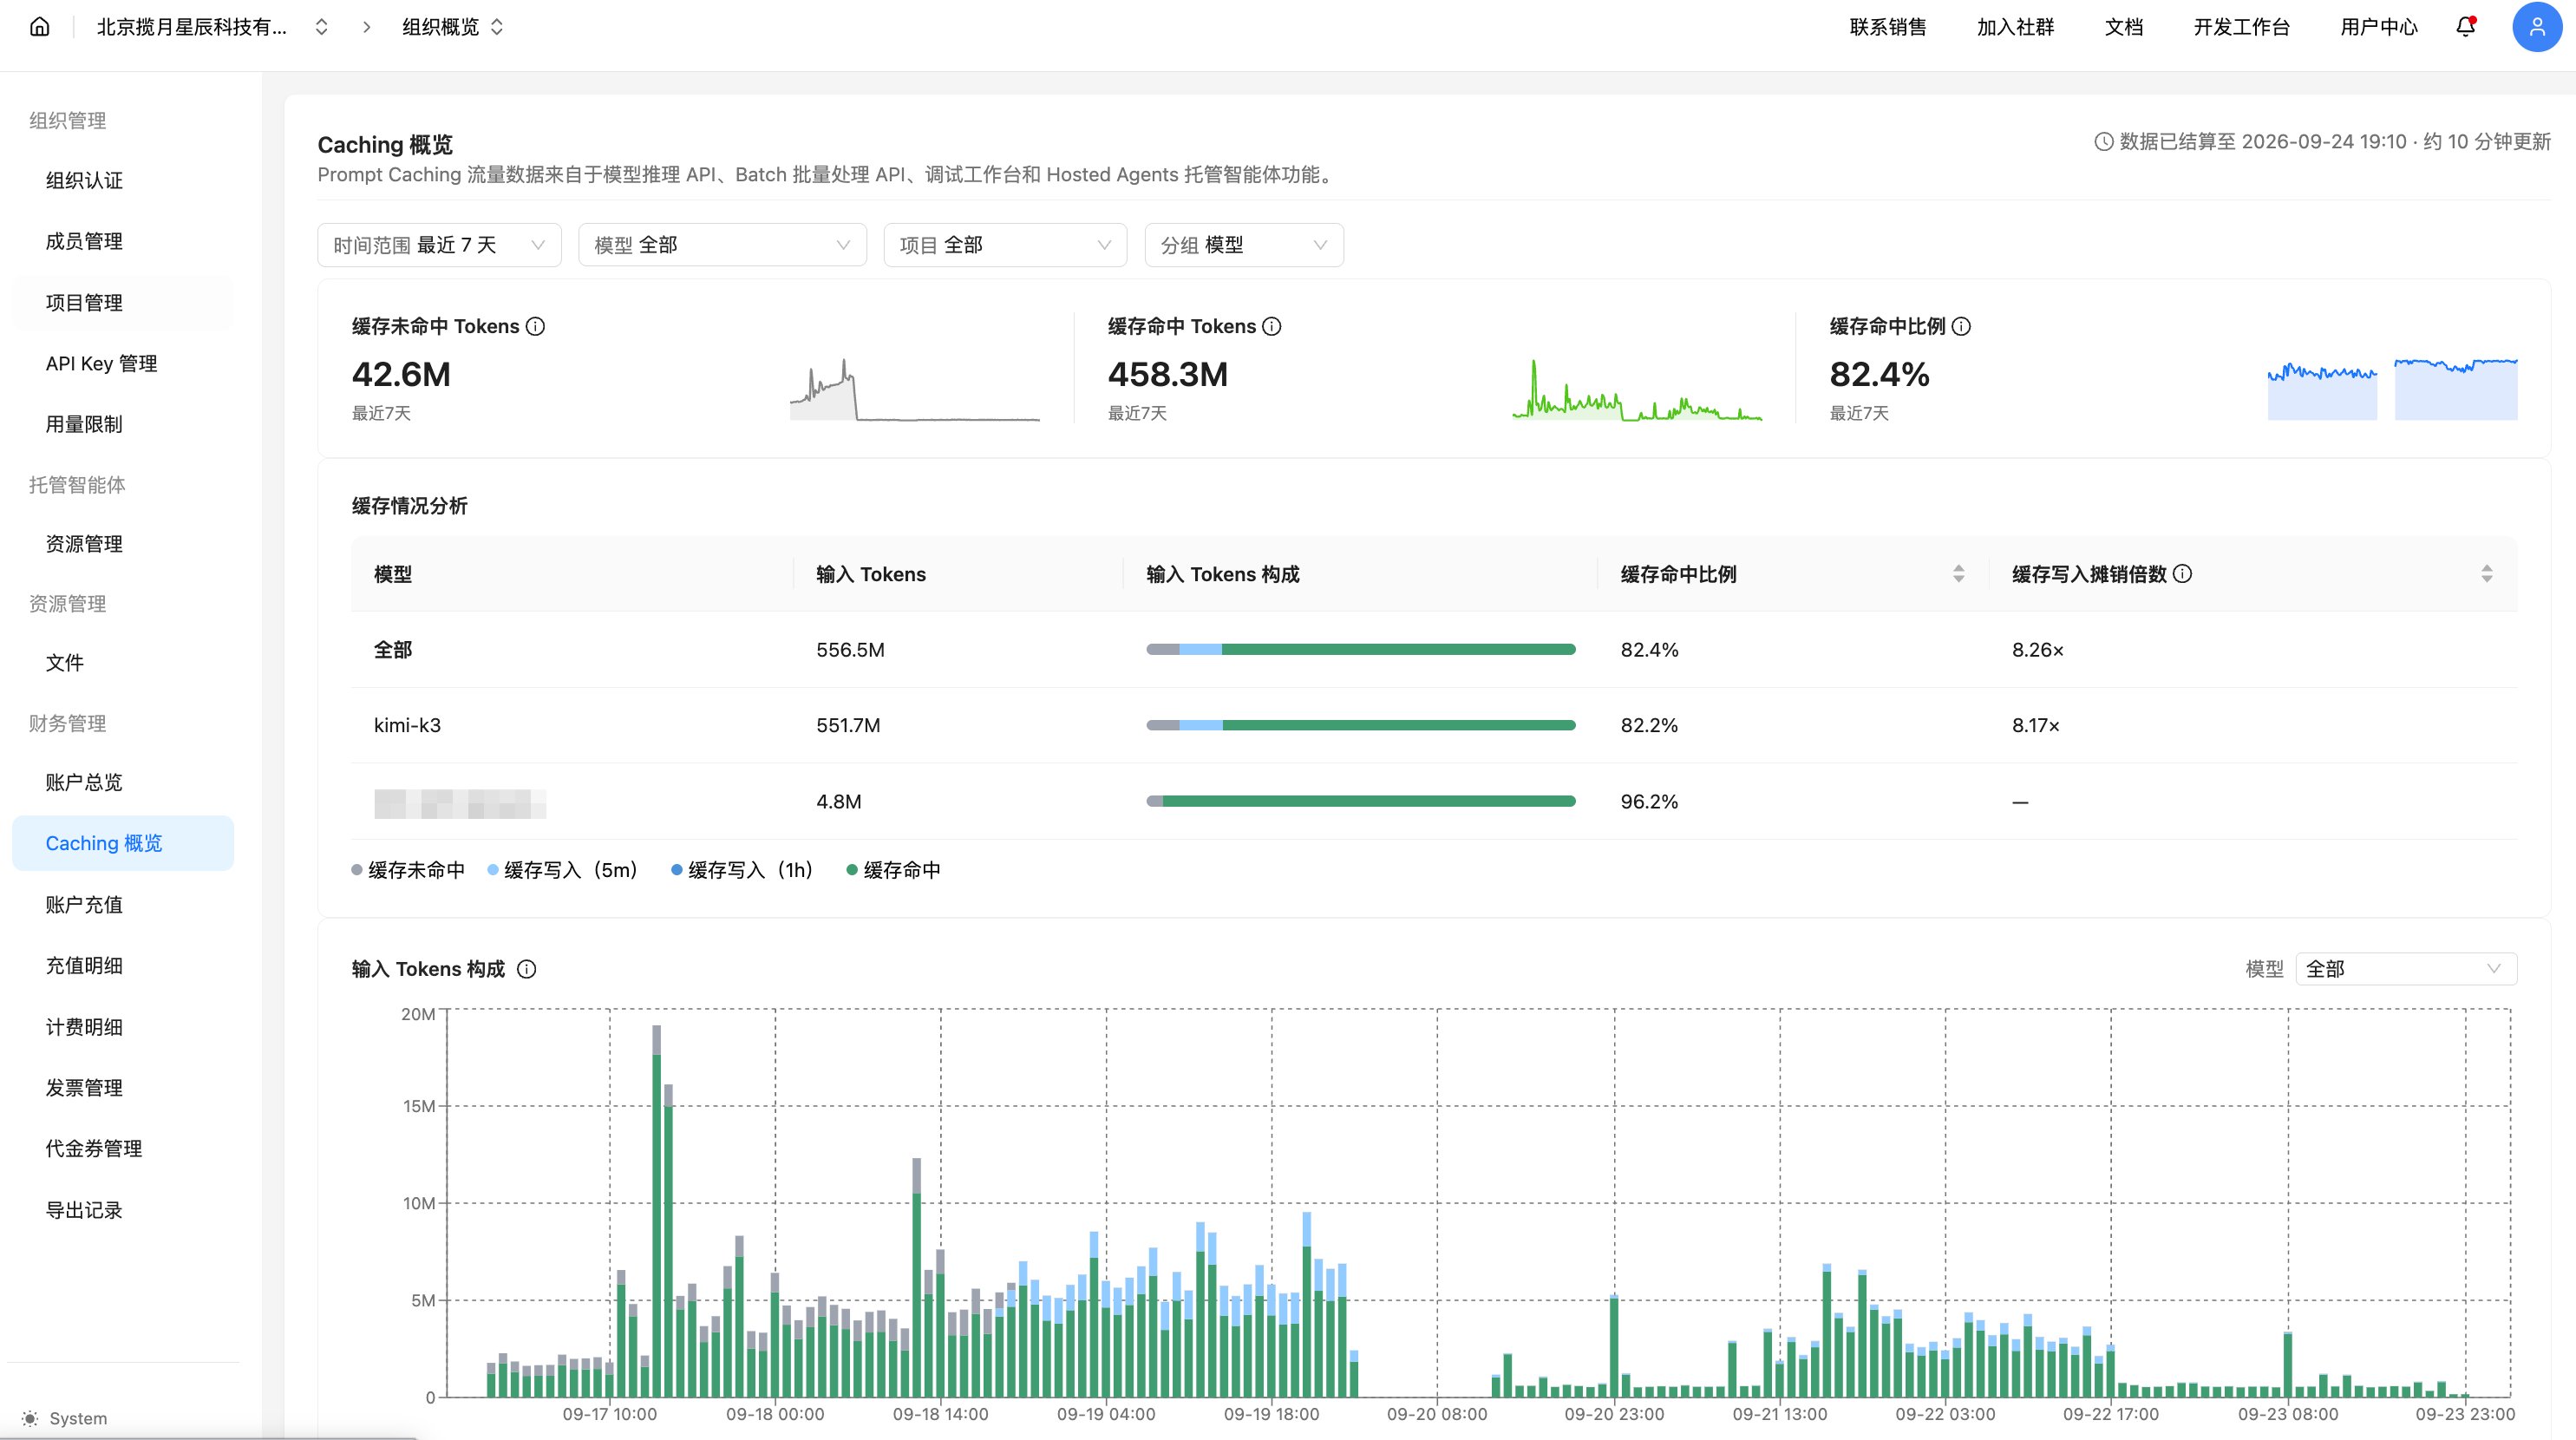
有。控制台新增 [Caching 概览页](https://platform.kimi.com/console/cache),可以查看各模型在时间范围内的缓存命中 / 未命中 / 缓存写入 tokens 构成、缓存命中率,以及缓存写入摊销倍数(缓存命中 tokens ÷ 缓存写入 tokens,数值越大代表缓存越划算)。
 ## 相关文档