> ## Documentation Index
> Fetch the complete documentation index at: https://platform.kimi.com/docs/llms.txt
> Use this file to discover all available pages before exploring further.
# 金融财务建模智能体设计
> 拆解官方金融财务建模智能体的单智能体 + 机构金融插件架构、写死在建模工作流里的数据纪律与假设显式化约定,附完整起点配置、运行成本测算与自建指引。
过去,分析师为一家上市公司搭建三表、完成 DCF 和可比公司分析,往往需要 **几天**。官方金融财务建模智能体把取数、规范化、预测、估值和质检串成流程,一次完整建模 **约 ¥30–50**、**约 45–90 分钟** 即可得到可编辑的 Excel 模型。以下是大致量级,实际以控制台账单为准。
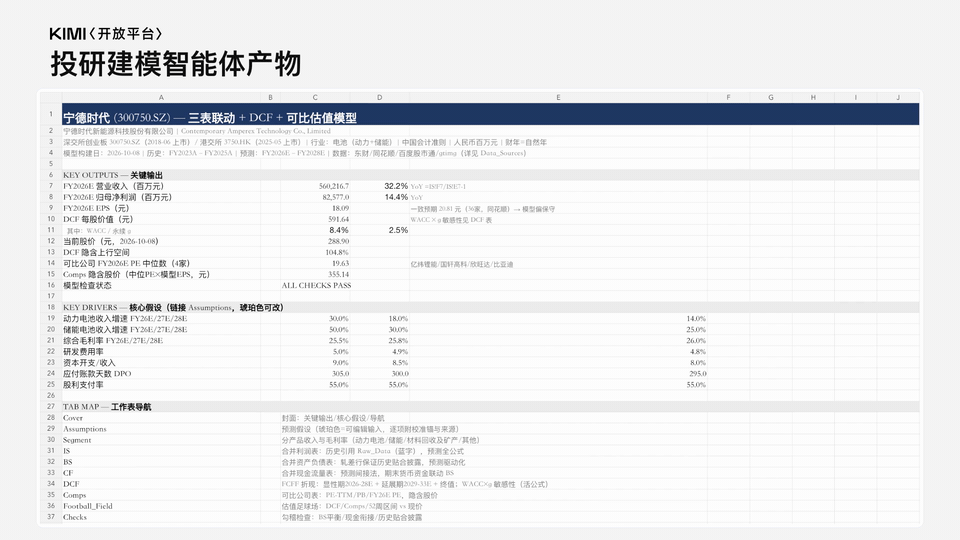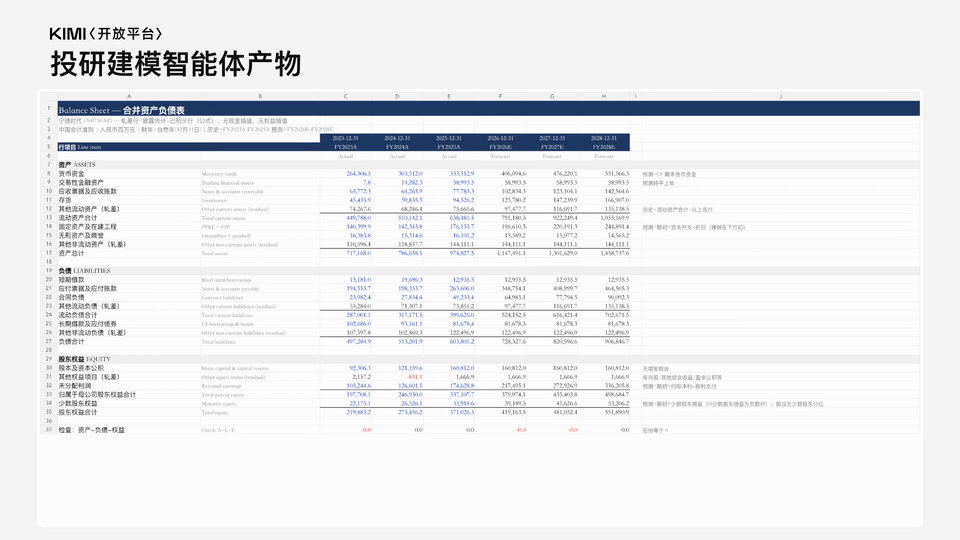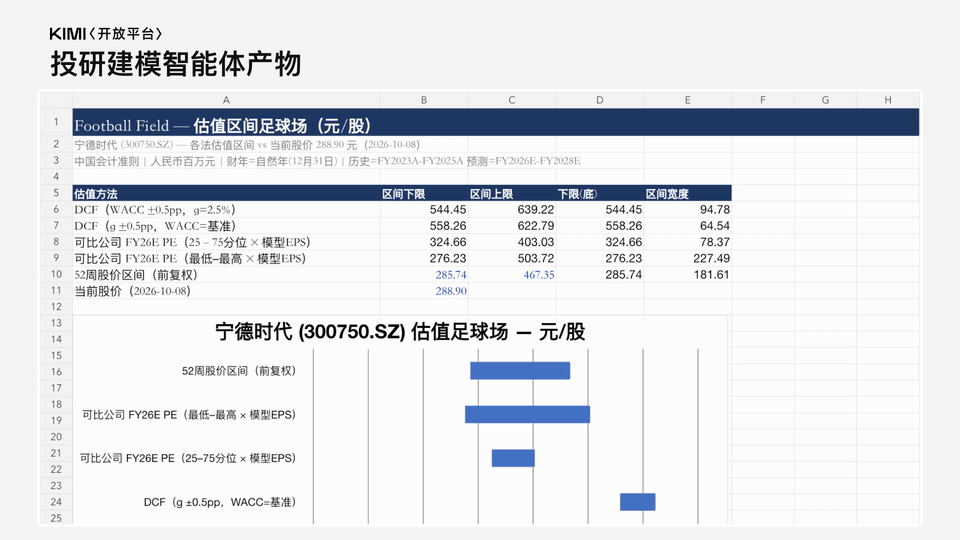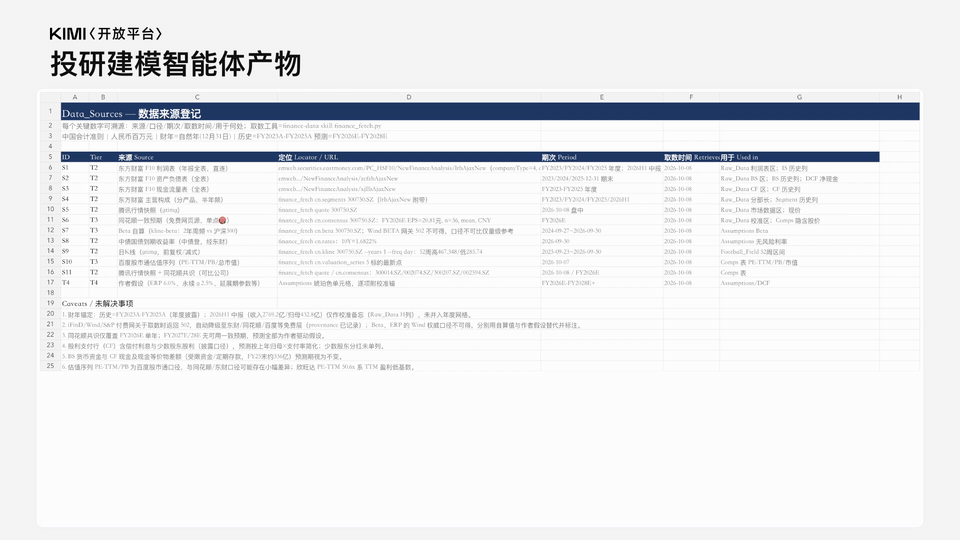
输入一个 ticker 或一份财务数据即可开始建模,产出公式可追踪、图表引用计算单元格的 Excel 工作文件。假设集中写在 Assumptions 表里,改一个数字,全模型联动重算。智能体只做建模,不执行交易,也不出投资建议。
 ## Agent 架构总览
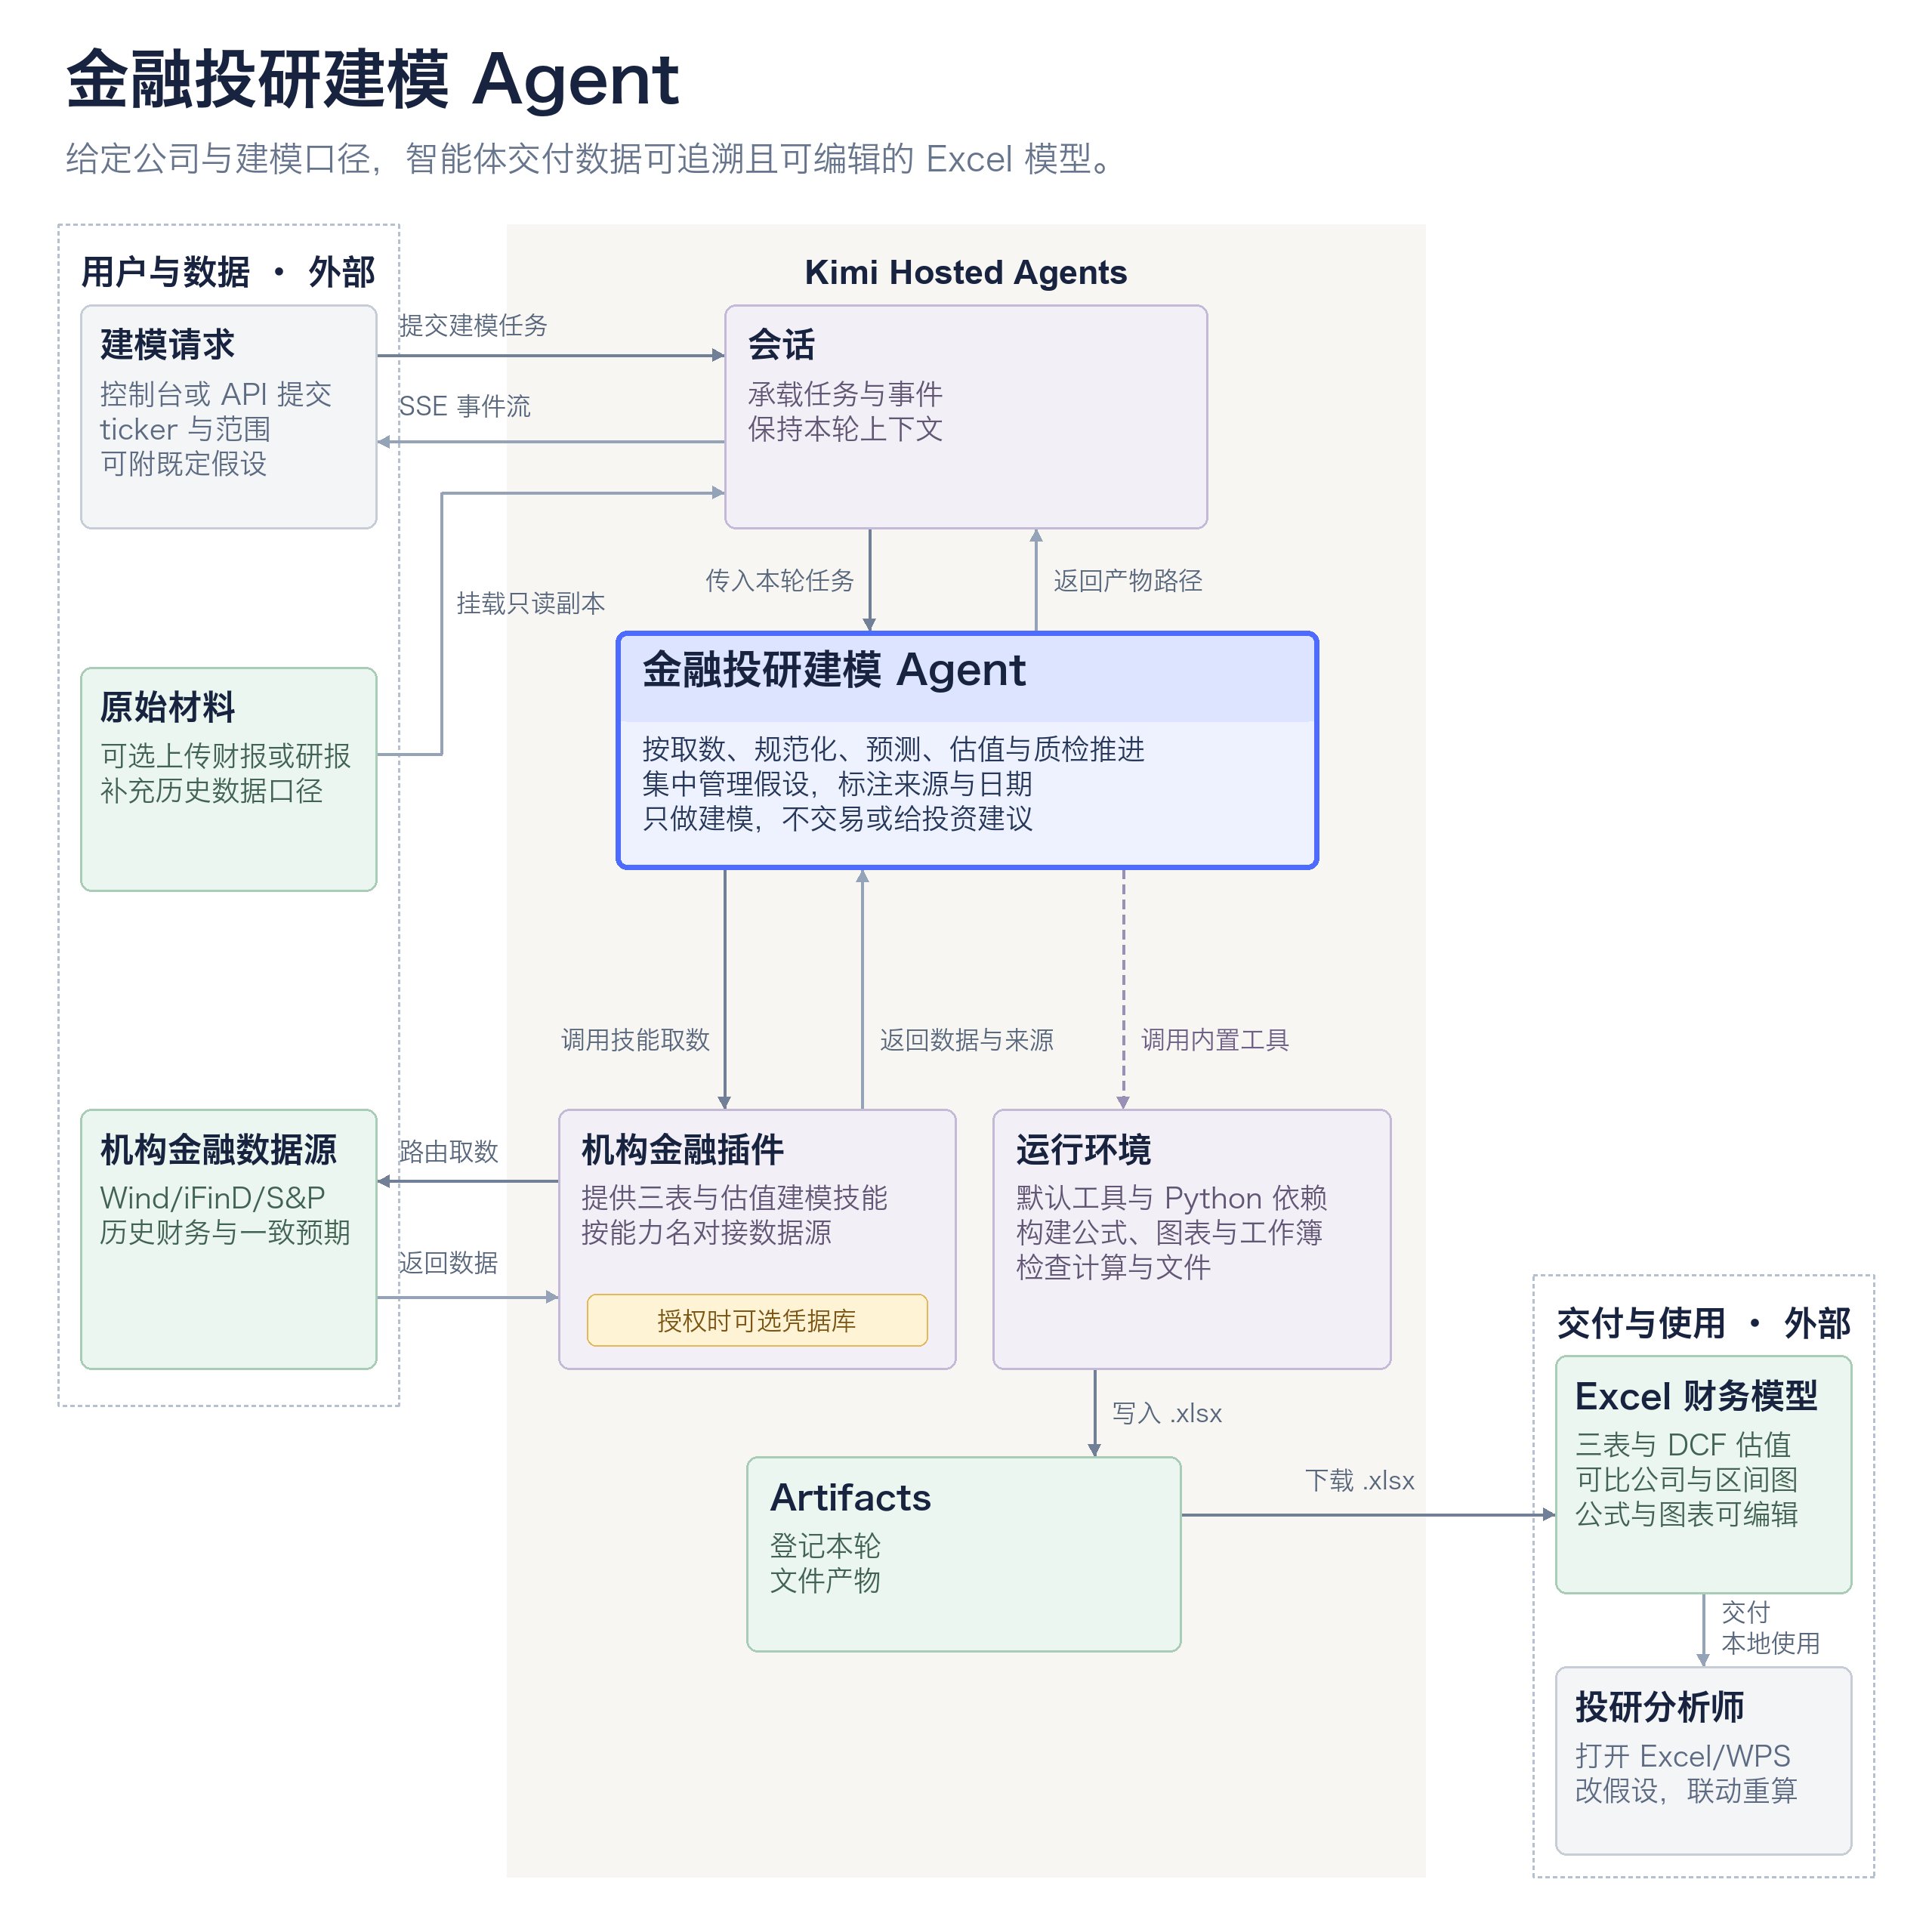 一次建模任务的数据流:
1. 调用方创建会话,下达任务:标的代码、模型范围、已有假设;手头有财报原文时先上传挂载;
2. 智能体通过机构金融插件的数据源路由取数——历史财务、市场一致预期、可比公司行情,每个关键输入标注来源和取数日期;
3. 取数齐备后开始搭模型:报表规范化、盈利预测、估值建模,全部假设集中写进 Assumptions 工作表;
4. 在沙箱里用 openpyxl 构建 .xlsx 工作簿:写公式、建图表、调格式,图表引用计算单元格而不是贴图;
5. 质检:检查表间勾稽(净利润进留存收益、现金变动对上货币资金),取不到的数在 `Data_Sources` 表注明原因;
6. 成品写入 `output/` 目录并登记为产物,调用方下载后用 Excel 或 WPS 打开继续改。
| 层 | 负责什么 | 能碰的数据 |
| - | - | - |
| 智能体(kimi-k3) | 执行建模工作流:取数、规范化、预测、估值、质检 | 插件数据源、用户上传的财报文件 |
| 机构金融插件 | 建模方法论(技能)+ 数据源路由 | Wind、同花顺 iFinD、S\&P 等数据源 |
| 云沙箱 | 用 openpyxl 真正构建 Excel 文件 | 会话文件系统,产物写入 `output/` |
建模是强顺序流程,取数未完成就不能进入预测和估值,因此采用单智能体,避免多智能体的协调成本。建模方法论和数据源接入交给插件,智能体按固定流程完成建模。
## 核心设计
**官方金融财务建模智能体的全部能力来自「模型 + 系统提示词 + 机构金融插件 + 默认内置工具集」的组合。它的设计目标有三条,后面每个配置选择都由此出发:**
* **产出必须是真 Excel**:公式可追踪、图表引用计算单元格、假设集中可改,而不是一张长得像模型的截图;
* **每个数字有来源**:关键输入标注数据源和取数日期,取不到的在 `Data_Sources` 表注明原因,严禁编造,缺失数据不当作零;
* **流程不能乱**:取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检,顺序写死,不跳步。
下面逐项拆解:官方怎么配的、为什么这样配、自建时怎么取舍。
### 系统提示词:把建模工作流写死
建模任务最容易出错的不是算错数,而是流程乱:先估值后取数、假设拍脑袋、来源不标。官方系统提示词的核心是把工作流顺序和数据纪律写死:
* **固定流程**:收到建模请求后,严格按「取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检」的顺序执行,不跳步;取数没完成,不许开始搭模型;
* **数据纪律**:所有取数经插件的数据源路由完成,每个关键输入标注来源和取数日期;取不到的数据在 `Data_Sources` 表注明原因,严禁编造,缺失数据不当作零(除非显式声明假设);
* **假设显式化**:WACC、永续增长率、预测期收入增速这类假设集中放在 Excel 的 Assumptions 工作表里,单元格可改,模型公式引用这些单元格,用户改一个假设,全模型联动;
* **护栏**:只做财务建模,不执行任何交易,不出投资建议;事实、计算、推断分开呈现;
* **产出约定**:成品写入 `output/` 目录,最终回复用相对路径列出(如 `output/CATL_model.xlsx`),客户端按约定取回。
### 插件:方法论和取数都交给机构金融插件
建模的取数和建模方法论都来自机构金融插件(`institutional-finance-kit`),它打包了两类东西:
* **建模技能**:插件里的 `institutional-financial-modeling` 技能定义了机构级三表、DCF 与可比估值的完整工作流:工作表怎么分、公式怎么搭、敏感性分析怎么做。产出的是机构级模型而不是玩具表,靠的就是这套技能;
* **数据源路由**:插件统一对接 Wind、同花顺 iFinD、S\&P 等数据源。智能体用「能力名」请求数据(如历史财务、市场一致预期),不需要关心具体供应商接口。
自建时按领域替换:做哪个领域的建模,就挂哪个领域的工作流插件。数据源需要授权时,凭据统一放在 [凭据库](/docs/hosted-agents/vaults),运行时注入,不进智能体配置。插件的引用方式和版本固定规则见 [插件](/docs/hosted-agents/plugins)。
### 工具:默认内置工具集已够用
工具用平台默认内置工具集,文件读写、代码运行、联网检索开箱即用。构建 Excel 靠代码运行(ipython)在沙箱里调 openpyxl;取数已由插件的数据源路由覆盖,一般不需要再接 MCP 服务,需要接时见 [接入 MCP](/docs/hosted-agents/mcp)。
## 配置选择
模型选 `kimi-k3`。选型考虑:建模要同时处理长财报原文、技能规范和大量结构化计算,对长上下文和指令遵循的要求都很高;多轮搭建过程中上下文持续增长,`kimi-k3` 的长上下文与缓存计价也能压住成本,见下文「运行成本」。
各项资源的配置如下:
| 资源 | 用途 | 本案例的选择 |
| - | - | - |
| 智能体 | 执行建模工作流 | 单智能体,`kimi-k3` |
| 插件 | 建模方法论 + 数据源路由 | 机构金融插件(`institutional-finance-kit`) |
| 技能 | 机构级建模工作流 | 插件里的 `institutional-financial-modeling` 技能,随插件挂载 |
| 执行环境 | 构建 Excel 与图表 | 云沙箱,`config` 声明 openpyxl、numpy、matplotlib 等 pip 依赖 |
| 文件 | 财报、券商研报、内部研究等原始材料(建议尽量多提供) | 上传后以只读副本挂载进会话 |
| 凭据库 | 数据源授权(可选) | 凭据放凭据库,创建会话时挂进 `resources` |
| 触发器 | 当前不需要 | 建模是按需任务,不设触发器 |
| 记忆库 | 当前不需要 | 每次建模独立成会话,不依赖跨会话记忆 |
## 运行成本
成本几乎全部来自模型 tokens;沙箱按运行时长计费(¥0.072 / 小时,一次建模约 45–90 分钟,不到 ¥0.1),可以忽略;文件上传与抽取限时免费,详见 [托管智能体定价](/docs/pricing/hosted-agents)。以 `kimi-k3` 的 [公开单价](/docs/pricing/chat),一次完整建模的大致量级:**几十元(约 ¥30–50)、约 45–90 分钟**。
以下为大致量级,**实际以控制台账单为准**——它随标的数据量、财报厚度、是否上传材料、以及取数和返工轮次大幅浮动。数据全的大公司和数据少的新上市标的能差好几倍;上传券商研报、内部研究等材料能让历史口径更准、减少取数轮次,成本和时间反而可能更低(见下文「第 3 步:准备原始材料」)。上述估算只是 2026 年 9 月底至 10 月初若干次生产会话的大致量级,不是固定价,实际以控制台账单为准。
一次完整建模的成本主要来自上下文累积:一次任务要经过多轮模型调用,每一轮都携带累积的上下文,累计输入可达上千万 tokens;其中约 95% 是重复前缀,命中上下文缓存后只按缓存命中价计费——上下文缓存是成本可控的关键,若没有缓存,同等输入量全部按未命中价计费,成本会是现在的六七倍。输出主要是 openpyxl 构建代码和最终回复。插件按调用次数另行计费,单价按插件分档,见 [托管智能体定价](/docs/pricing/hosted-agents),未计入上述估算。
**建议客户自己准备研报和数据源**:建模质量的上限很大程度由输入材料决定。券商研报、私有数据、内部研究、历史财务原文这些,平台无法直接提供(受版权和合规限制),需要客户自己准备并上传,或自行接入私有信息源(见下文「第 3 步」)。材料越全,历史数据口径越准、假设越有依据、分析越深入,且往往能省掉一部分取数轮次。
## 从最小版本开始搭建
最小起点是「单智能体 + 机构金融插件」:插件自带建模技能和数据源,挂上就能跑。下面按步骤走一遍。
### 第 1 步:创建智能体
下面是一个可运行的创建命令(不是官方配置的逐字拷贝,官方当前配置以 `GET /v1/agents` 返回为准):
```bash cURL theme={null}
curl -X POST https://api.moonshot.cn/v1/agents \
-H "Authorization: Bearer $KIMI_API_KEY" \
-H "kimi-api-version: 2026-09-01-beta" \
-H "Content-Type: application/json" \
-d '{
"name": "我的财务建模助手",
"model": {"id": "kimi-k3"},
"system": "你是一个金融财务建模智能体,职责是把一家公司变成一份可编辑的 Excel 财务模型。\n- 严格按流程执行:取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检,取数未完成不得开始搭模型。\n- 所有数据通过插件的数据源路由获取,每个关键输入标注来源与取数日期;取不到的数据在 Data_Sources 表注明原因,严禁编造。\n- 缺失数据不当作零,除非显式声明假设。\n- 所有假设(WACC、永续增长率、收入增速等)集中放在 Excel 的 Assumptions 工作表,模型公式引用假设单元格,改假设可联动重算。\n- 产出包含:三表、DCF(含敏感性分析)、Peer Comps、Football Field 估值区间图,图表引用计算单元格,不用图片贴片。\n- 只做财务建模,不执行任何交易,不出投资建议;事实、计算、推断分开呈现。\n- 成品写入 output/ 目录,最终回复用相对路径逐一列出。",
"plugins": [
{"plugin_id": "<机构金融插件 ID>"}
],
"description": "自建财务建模智能体:输入 ticker,产出可编辑 Excel 三表 + DCF 模型"
}'
```
```bash CLI theme={null}
kha agents create --file - <<'JSON'
{
"name": "我的财务建模助手",
"model": {"id": "kimi-k3"},
"system": "你是一个金融财务建模智能体,职责是把一家公司变成一份可编辑的 Excel 财务模型。\n- 严格按流程执行:取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检,取数未完成不得开始搭模型。\n- 所有数据通过插件的数据源路由获取,每个关键输入标注来源与取数日期;取不到的数据在 Data_Sources 表注明原因,严禁编造。\n- 缺失数据不当作零,除非显式声明假设。\n- 所有假设(WACC、永续增长率、收入增速等)集中放在 Excel 的 Assumptions 工作表,模型公式引用假设单元格,改假设可联动重算。\n- 产出包含:三表、DCF(含敏感性分析)、Peer Comps、Football Field 估值区间图,图表引用计算单元格,不用图片贴片。\n- 只做财务建模,不执行任何交易,不出投资建议;事实、计算、推断分开呈现。\n- 成品写入 output/ 目录,最终回复用相对路径逐一列出。",
"plugins": [
{"plugin_id": "<机构金融插件 ID>"}
],
"description": "自建财务建模智能体:输入 ticker,产出可编辑 Excel 三表 + DCF 模型"
}
JSON
```
创建成功后,从响应中保存 `id` 作为 `AGENT_ID`。插件 ID 用 `GET /v1/plugins` 列出后按显示名「机构金融插件」查找,或在控制台智能体表单中直接勾选。之后按需调整的字段:
| 字段 | 调整频率 | 怎么调 |
| - | - | - |
| `system` | 最常改 | 固定市场范围(A 股/港股/美股)、会计准则、默认假设口径、产出模板 |
| `plugins` | 按领域改 | 换成其他领域的工作流插件,或叠加数据类插件 |
| `model` | 一般不动 | `kimi-k3` 已适配长文档分析与结构化产出 |
| 工具集 | 一般不动 | 默认内置工具集已够用,无需声明 |
### 第 2 步:创建执行环境
建模需要 openpyxl、numpy、matplotlib 等 Python 库来构建 Excel 和图表。创建云沙箱环境时在 `config` 里声明 `pip` 依赖;如果数据源走内网网关,把对应域名加进网络白名单,详见 [执行环境](/docs/hosted-agents/environments)。从响应中保存 `id` 作为 `ENVIRONMENT_ID`。
### 第 3 步:准备原始材料(建议尽量多提供)
建模质量的上限很大程度由输入材料决定。**建议尽可能多地提供资料**:券商研报、私有数据、内部研究、历史财务原文等。材料越全,历史数据口径越准、假设越有依据、分析越深入——有原始材料的建模,质量明显高于纯靠插件检索。需要说明:平台无法直接提供券商研报等受版权保护的资料,需要你自己准备并上传,或自行接入私有信息源。提供方式有两种:
1. **直接上传 PDF**:把研报、财报、内部材料通过 `POST /v1/files` 上传拿到 `file_id`,创建会话时挂进 `resources`,文件以只读副本出现在沙箱的 `/mnt/agents/upload/` 下,详见 [文件](/docs/hosted-agents/files);
2. **MCP + 凭据库连私有信息源**:如果机构有自己的数据服务(Wind、内部研报库、私有数据库),可以包成 MCP 服务挂进智能体,凭据放 [凭据库](/docs/hosted-agents/vaults),创建会话时把凭据库挂进 `resources`(绑定只在创建时生效),运行时自动注入。数据授权关系留在机构与数据商之间,平台不碰数据,详见 [接入 MCP](/docs/hosted-agents/mcp)。
### 第 4 步:创建会话并下达任务
[快速开始](/docs/hosted-agents/quickstart) 已经完整走过一遍调用流程,这里只展示建模任务的特有部分。创建会话:
```bash cURL theme={null}
curl -X POST https://api.moonshot.cn/v1/sessions \
-H "Authorization: Bearer $KIMI_API_KEY" \
-H "kimi-api-version: 2026-09-01-beta" \
-H "Content-Type: application/json" \
-d '{
"agent_id": "'"$AGENT_ID"'",
"environment_id": "'"$ENVIRONMENT_ID"'",
"title": "宁德时代 DCF 模型"
}'
```
```bash CLI theme={null}
kha sessions create --agent "$AGENT_ID" --environment "$ENVIRONMENT_ID" --title "宁德时代 DCF 模型"
```
从响应中保存会话 `id` 作为 `SESSION_ID`,订阅事件流(见 [快速开始](/docs/hosted-agents/quickstart)),然后下达任务:
```bash cURL theme={null}
curl -X POST https://api.moonshot.cn/v1/sessions/$SESSION_ID/events \
-H "Authorization: Bearer $KIMI_API_KEY" \
-H "kimi-api-version: 2026-09-01-beta" \
-H "Content-Type: application/json" \
-d '{
"events": [
{
"type": "user.message",
"data": {
"content": [
{"type": "text", "text": "帮我搭建宁德时代(300750.SZ)的 DCF 模型:规范化最近三年三张表,预测未来三年,给出 DCF 估值(含敏感性分析)、可比公司分析和 Football Field 估值区间图。所有数据标注来源与取数日期,假设集中在 Assumptions 表,产出可编辑的 .xlsx。"}
]
}
}
]
}'
```
```bash CLI theme={null}
kha sessions send "$SESSION_ID" "帮我搭建宁德时代(300750.SZ)的 DCF 模型:规范化最近三年三张表,预测未来三年,给出 DCF 估值(含敏感性分析)、可比公司分析和 Football Field 估值区间图。所有数据标注来源与取数日期,假设集中在 Assumptions 表,产出可编辑的 .xlsx。"
```
同一个智能体,任务描述决定产出质量,上面这条就是一个合格示例。以下三条原则按重要性排序:
1. **给代码,不只给名字。** 市场(A 股 / 港股 / 美股)和标的是建模最先要确定的信息,给代码能避免同名歧义。写「宁德时代(300750.SZ)」,而不是「帮我看看宁德」。
2. **说清模型范围。** 默认产出三表 + DCF + Peer Comps + Football Field 全套;只要其中一部分就点名,例如「只要三表和 DCF,不要可比公司」。要加情景分析(乐观 / 中性 / 悲观)也在任务里说。
3. **有假设就给假设,有材料就多给材料。** 手头有既定假设(比如公司指引的收入增速、投委会定的 WACC 区间)直接写进任务,智能体会把它们填进 Assumptions 表,而不是用默认值。财报原文、券商研报、内部研究更是越多越好(见上文「第 3 步」),历史数据口径和假设依据都会明显更扎实。
### 第 5 步:取回产物
会话回到 `idle` 后,先列出该会话的产物,找到 Excel 文件的产物 `id`:
```bash cURL theme={null}
curl "https://api.moonshot.cn/v1/artifacts?session_id=$SESSION_ID" \
-H "Authorization: Bearer $KIMI_API_KEY" \
-H "kimi-api-version: 2026-09-01-beta"
```
```bash CLI theme={null}
kha artifacts list --session "$SESSION_ID"
```
再下载成品:
```bash cURL theme={null}
curl "https://api.moonshot.cn/v1/artifacts/$ARTIFACT_ID/content" \
-H "Authorization: Bearer $KIMI_API_KEY" \
-H "kimi-api-version: 2026-09-01-beta" \
-o CATL_model.xlsx
```
```bash CLI theme={null}
kha artifacts download "$ARTIFACT_ID" --out CATL_model.xlsx
```
产物列表为空或需要中间文件时,用 `GET /v1/sessions/$SESSION_ID/filesystem` 浏览会话文件系统,详见 [文件](/docs/hosted-agents/files)。
产物是一个 .xlsx 工作簿,用 Excel 或 WPS 打开后可以直接改。里面按工作表组织:
* **Assumptions**:全部假设集中在这一张表,包括 WACC、永续增长率、预测期收入增速、利润率假设。其他表的公式引用这里的单元格,改一个数全模型联动;
* **三表**:资产负债表、利润表、现金流量表,历史三年规范化 + 未来三年预测,DCF 延展期五年,表间勾稽(利润表净利润进资产负债表留存收益、现金流量表现金变动对上资产负债表货币资金);
* **DCF**:自由现金流预测、折现、终值、企业价值到股权价值的桥,附 WACC × 永续增长率的敏感性矩阵;
* **Peer Comps**:同行业可比公司的估值对比表,含 PE-TTM、PB、前瞻 PE 等指标,数据来自插件的数据源路由;
* **Football Field**:不同估值方法(DCF、可比公司、历史区间)的估值范围对比图,图表引用计算单元格,不是贴图;
* **Checks**:把勾稽检查写进产物,资产负债表平衡、现金流与资产负债表衔接、收入衔接等检查项逐期列出差额和 PASS / REFERENCE 状态,打开文件就能核对模型是否配平。
假设的来源和校准锚写在 Assumptions 表的依据 / 来源列;全部取数在 `Data_Sources` 表逐条登记(来源、定位、期次、取数时间、用在哪张表),取不到的数也在这张表注明原因。文件保存在会话的 `output/` 目录,通过产物接口下载后可以继续改,这正是它和「生成一段分析文字」的本质区别。
## 运行与观察
建模是长任务,取数加搭模型通常要 45 分钟到 1.5 小时,触顶重试时更长,建议在事件流里盯到结束。判断一次运行是否正常,看这几处:
* **`session.status`**:`running` 表示开工,回到 `idle` 表示本轮完成,可以下载产物;
* **`agent.tool_use`**:能看到每次取数调的是哪个数据源、什么口径,数据不对时,问题通常出在这一步;
* **`session.error`**:任务失败时出现,携带错误类型与信息。
订阅事件流的连接可能中途断开,用断开前最后一帧 SSE 消息的 `id:` 字段作为 `cursor` 重新订阅即可续读,详见 [事件流](/docs/hosted-agents/event-stream)。
以下观察点是建模场景独有的:
| 看哪里 | 看什么 | 说明什么 |
| - | - | - |
| `agent.tool_use` 的取数调用 | 数据源、口径、取数日期 | 历史数据口径不对,通常是这里取错了 |
| ipython 执行记录 | openpyxl 构建代码是否报错 | 产物没生成时,先看构建代码有没有异常 |
| 最终回复的文件清单 | 是否列出了 `output/` 下的 .xlsx | 只列了中间文件说明质检没通过或流程被跳过 |
## 可扩展方向
* **批量建模**:多个标的各建一个会话并发跑,产出按会话分别取回,互不干扰;
* **嵌入自有系统**:把托管智能体 API 接进自己的投研平台,由你的业务系统创建会话、订阅事件流、取回 Excel,分析师在自己的界面里拿到模型继续改;
* **多智能体拆分**:取数、搭模型、质检拆成专职子智能体,委派配置写在 `multiagent` 字段里,详见 [多智能体编排](/docs/hosted-agents/multiagent-orchestration)。先把「单智能体 + 插件」跑通,再考虑拆分。
## 下一步
插件的引用方式、版本固定与数据源路由。
上传财报材料、挂载会话与取回 Excel 产物。
云沙箱的 pip 依赖声明与网络白名单。