

Agent 架构总览
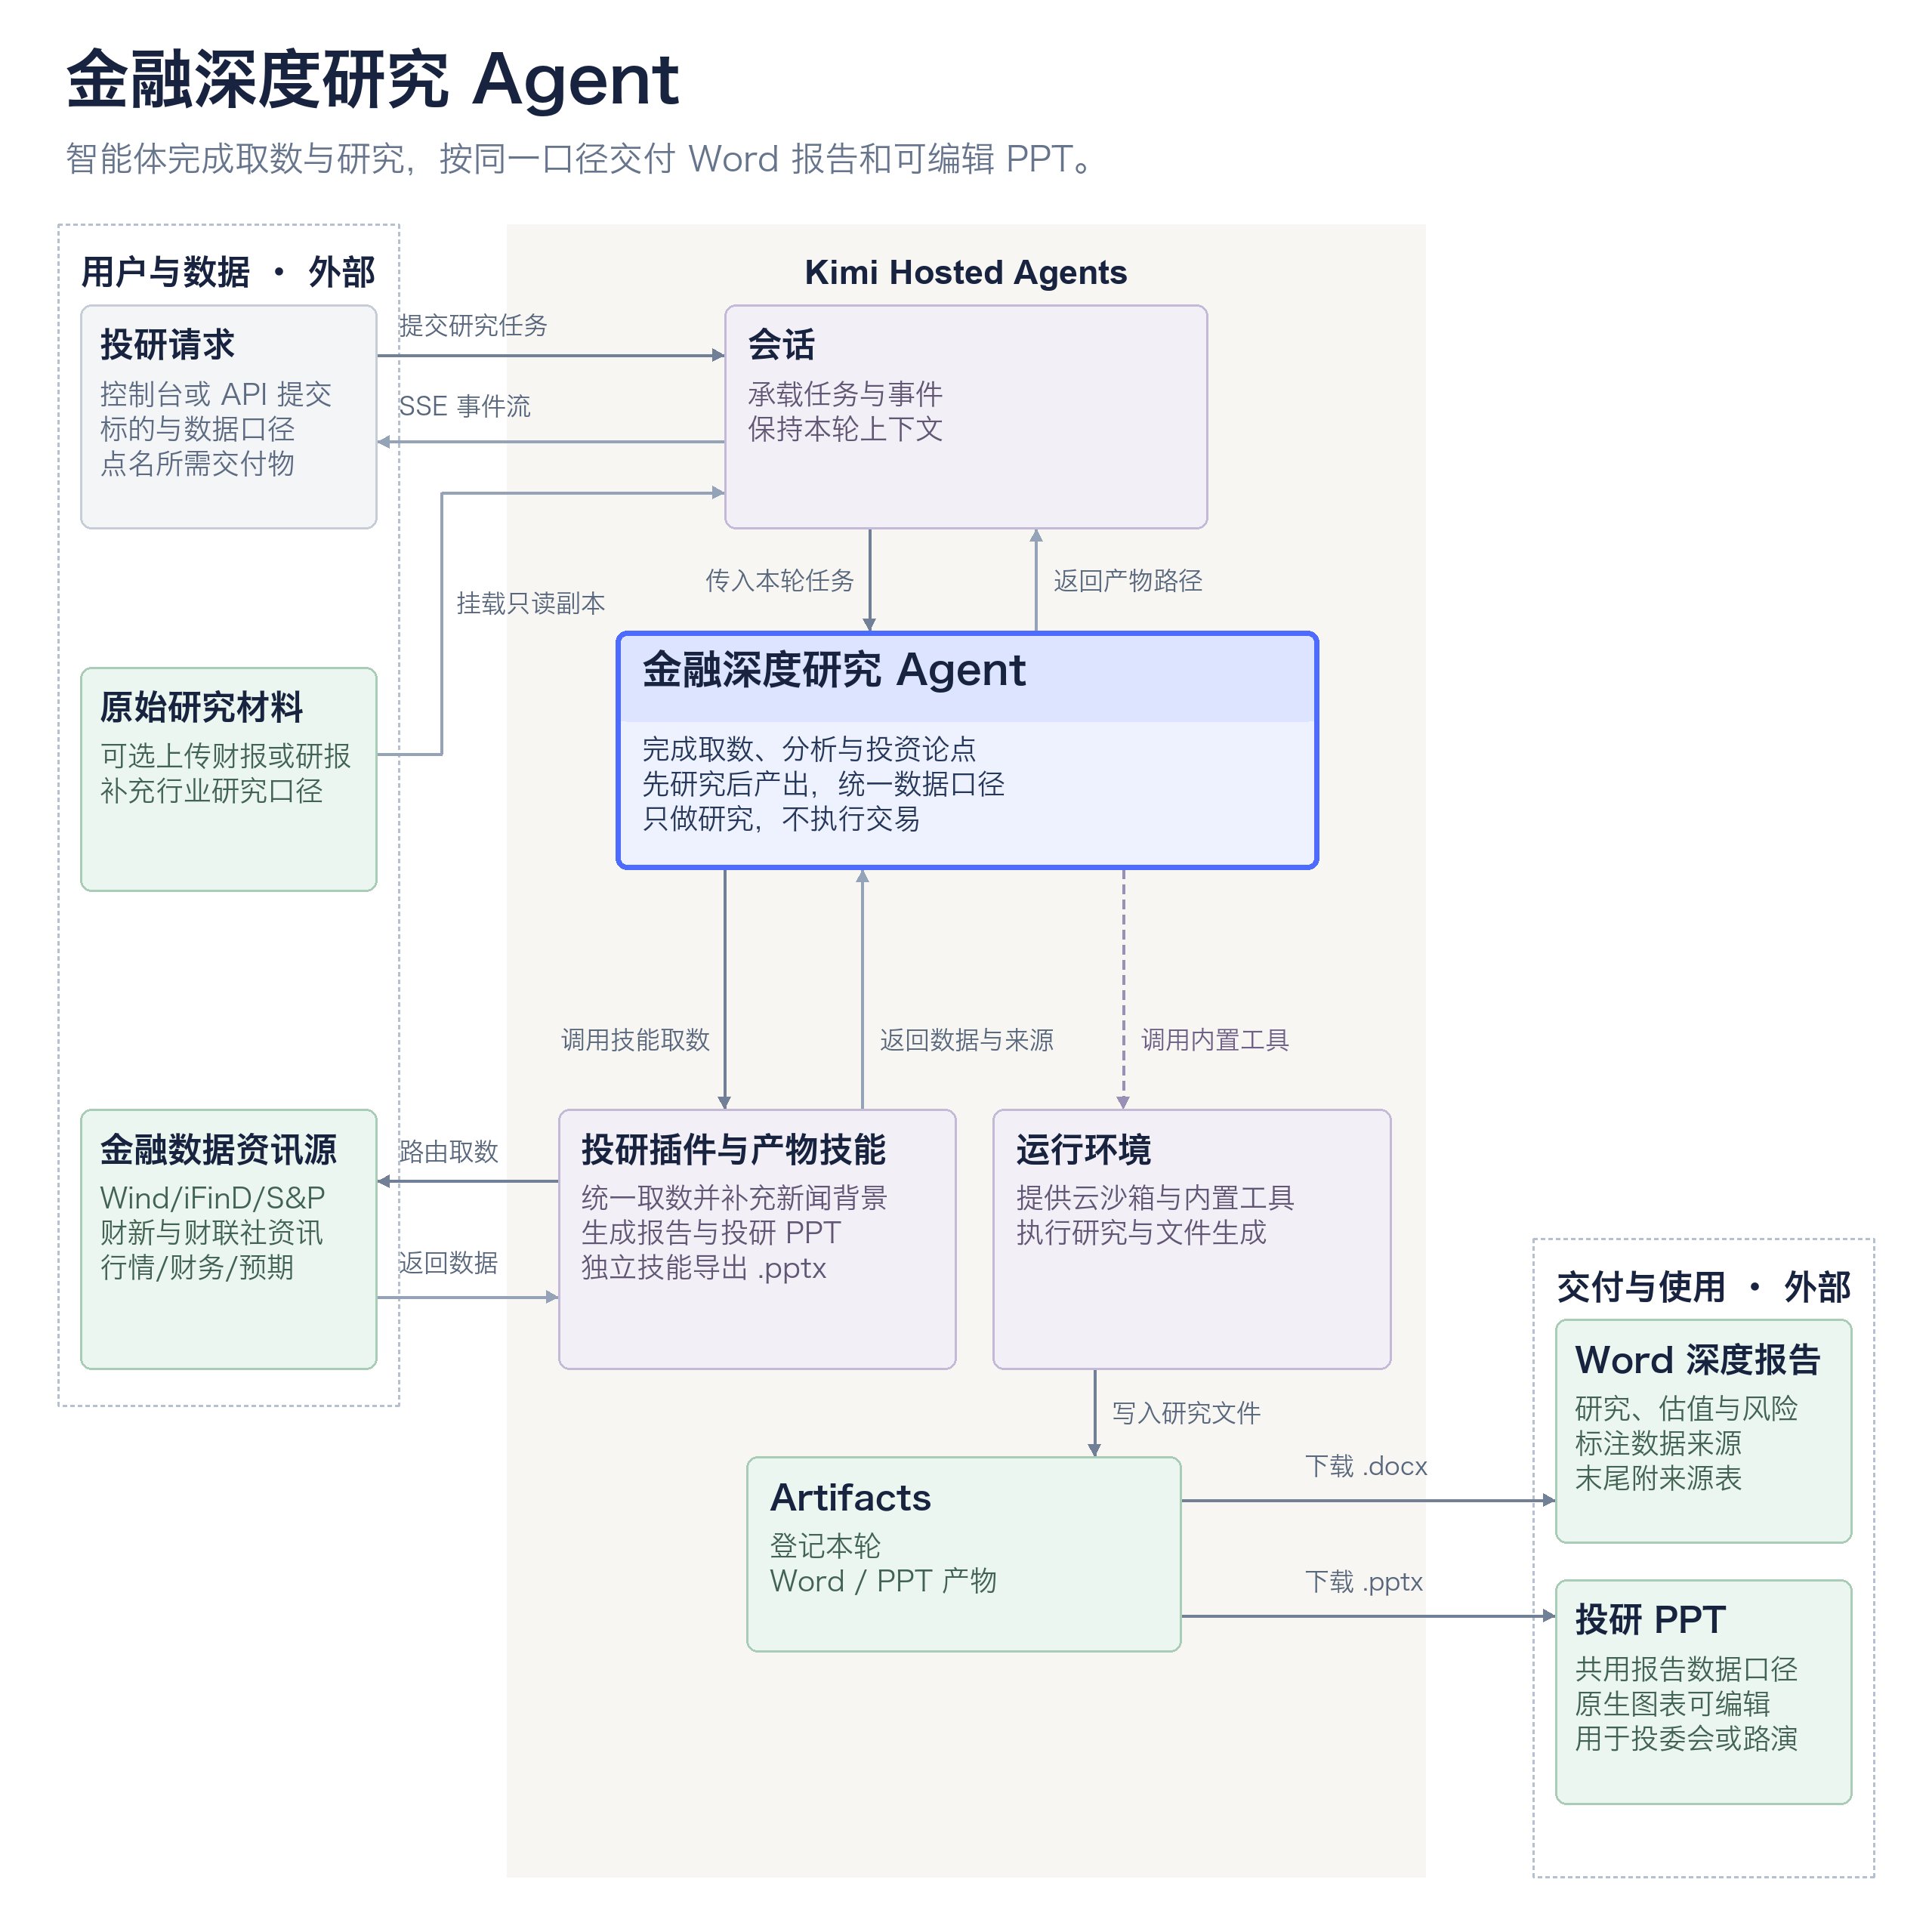
- 调用方上传财报、研报等原始材料拿到
file_id,创建会话时挂进resources,文件以只读副本出现在沙箱的/mnt/agents/upload/下; - 调用方下达任务,点名标的、数据口径和产物(Word 报告、PPT,或两者都要);
- 智能体进入研究阶段:通过金融投资分析(企业版)插件拉取行情、财务与一致预期,通过财新数据、财联社资讯插件补充行业动态与近期事件,结合上传材料形成完整研究结论;
- 研究结论定稿后进入产出阶段:走机构金融插件里的
institutional-research-report技能生成 Word 深度报告; - 同一份研究结论交给机构金融插件里的
institutional-slides技能规划 storyline,再由独立技能ha-slides-pptx保证落盘为所有元素可编辑的原生 .pptx; - 两个产物写入会话的
output/目录并登记为产物,调用方通过产物接口取回。
研究阶段先统一口径,产出阶段只用定稿结论,避免边写边查导致前后数字不一致。单智能体即可保留研究上下文,无需为这条链路拆分角色。
核心设计
官方金融深度研究智能体的全部能力来自「模型 + 系统提示词 + 插件 + 一个独立技能」的组合,工具用平台默认内置工具集。它的设计目标有三条,后面每个配置选择都由此出发:- 一条链路走到底:从取数到 Word 报告再到 PPT 不中断,任务里点名要什么就交付什么;
- 一套口径贯穿始终:市场、币种、会计准则、取数日期在任务开始时确定,报告和 PPT 用同一套数字;
- 取不到就进附录来源表:数据源查不到或口径对不上的内容,在报告末尾的附录来源表里注明原因,不允许编造数字填坑。
系统提示词:把「研究 → 交付」的链路写死
系统提示词的核心不是角色扮演,而是把长链路的工作顺序和交接规则写清楚,让智能体不会在中间某一步停下来交差。关键约定有四条:- 先研究后产出:收到任务先完成取数和分析,形成完整的研究结论,再进入产出阶段。不允许「边写边查」,报告里的每个数字都必须来自已经取回的数据;
- 产物点名制:任务里点名要什么就产出什么。说「深度研究报告」就走机构金融插件里的
institutional-research-report技能出 Word;说「IC PPT」「路演材料」就走institutional-slides技能出 PPT。两个都要就先后产出,共用同一份研究结论,不重复取数; - 数据口径一次说清:市场、币种、会计准则、取数日期在任务开始时确定,报告和 PPT 用同一套口径,PPT 里的数字必须能对应回报告的章节;
- 取不到就进附录来源表:数据源查不到或口径对不上的内容,在报告末尾的附录来源表里注明原因,不允许编造数字填坑。
插件:四件套各管一段
这个智能体挂了四个插件,每个负责链路上的一段,自建时按你的链路长度裁剪:
为什么深度研究要单独挂新闻源,而建模智能体不用: 深度报告里「行业趋势」「近期催化剂」「风险提示」这些章节靠的是新闻和事件,不是财务数据;金融财务建模智能体 的产出是 Excel 模型,用不到。自建时如果你的研究不需要新闻背景,这两个插件可以省掉。
数据源需要授权时,凭据统一放在 凭据库,运行时注入,不进智能体配置。插件的引用方式和版本固定规则见 插件。
独立技能:ha-slides-pptx 保证 PPT 是真文件
除了插件里的技能,这个智能体还单独挂了一个独立技能 ha-slides-pptx,与 PPT 助手 使用的产物技能相同。原因是两种 PPT 的产出方式不同:
institutional-slides(插件里的技能):走机构投研 deck 的规范,先梳理 storyline,再生成麦肯锡 / 外资行风格的页面,图表用 PPT 原生 chart;ha-slides-pptx(独立技能):保证最终落盘的是所有元素可编辑的原生 .pptx 文件(文本框、表格、原生图表),而不是图片贴片或.pptd中间格式。
.pptd 格式,说明导出环节没走通,检查环境里有没有配 PPT 导出所需的凭据和网络白名单(导出服务域名要放行)。
配置选择
模型统一使用kimi-k3。选型考虑:深度研究要通读财报、招股书、行业研报这类长文档,产出本身也是长文档(几十页的 Word 报告加二十页 PPT),对长上下文输入和长文档输出的要求都是六个金融智能体里最高的。自建时这个字段一般不动。
各项资源的配置如下:
运行成本
成本几乎全部来自模型 tokens;沙箱按运行时长计费(¥0.072 / 小时,一次深度研究约 1–3 小时,不到 ¥0.2),可以忽略;文件上传与抽取限时免费,详见 托管智能体定价。以kimi-k3 的 公开单价,成本和时间主要随报告页数(研究深度)浮动:
以下为大致量级,实际以控制台账单为准——它随报告页数/深度、标的数据可得性、是否上传材料、以及取数和返工轮次浮动。上传券商研报、内部研究等材料能让分析更准、减少取数轮次(见下文「第 3 步:准备原始材料」)。上表只是若干次生产会话的大致量级,不是固定价,实际以控制台账单为准。
建议客户自己准备研报和数据源:报告质量的上限很大程度由输入材料决定。券商研报、私有数据、内部研究、历史财务原文这些,平台无法直接提供(受版权和合规限制),需要客户自己准备并上传,或自行接入私有信息源(见下文「第 3 步」)。材料越全,历史数据口径越准、假设越有依据、分析越深入。
从最小版本开始搭建
下面是一个可运行的最小起点:单智能体 + 四个插件 + 一个独立技能,分五步跑通。它不是官方配置的逐字拷贝,官方当前配置以GET /v1/agents 返回为准。
第 1 步:创建智能体
插件 ID 用GET /v1/plugins 列出后按显示名查找(「机构金融插件」「金融投资分析(企业版)」「财新数据」「财联社资讯」),或在控制台智能体表单中直接勾选:
id 作为 AGENT_ID。之后按需调整的字段:
第 2 步:创建执行环境
通用云沙箱即可,config 传 {"type": "cloud"},详见 快速开始。注意两点:PPT 导出需要放行导出服务的域名;用到 SEC、美联储等境外官方数据源时,对应主机要加进网络白名单。从响应中保存 id 作为 ENVIRONMENT_ID。
第 3 步:准备原始材料并创建会话
研究质量的上限很大程度由输入材料决定。建议尽可能多地提供资料:券商研报、私有数据、内部研究、历史财务原文等。材料越全,报告的历史数据口径越准、论点依据越扎实、分析越深入——有原始材料的研究,质量明显高于纯靠插件检索。需要说明:平台无法直接提供券商研报等受版权保护的资料,需要你自己准备并上传,或自行接入私有信息源。提供方式有两种:- 直接上传 PDF:把研报、财报、行业材料通过
POST /v1/files上传拿到file_id,创建会话时挂进resources,文件以只读副本出现在沙箱的/mnt/agents/upload/下,详见 文件; - MCP + 凭据库连私有信息源:如果机构有自己的数据服务(Wind、内部研报库、私有数据库),可以包成 MCP 服务挂进智能体,凭据放 凭据库,创建会话时把凭据库挂进
resources(绑定只在创建时生效),运行时自动注入。数据授权关系留在机构与数据商之间,平台不碰数据,详见 接入 MCP。
FILE_ID,创建会话时挂进 resources(没有原始材料就省略该字段):
第 4 步:下达任务
从响应中保存会话id 作为 SESSION_ID,订阅事件流后下达任务。任务描述要点名产物,这一个动作决定智能体走到链路的哪一段:
- 说清标的和深度。 给公司代码避免同名歧义;「深度研究」「首次覆盖报告」「IC Memo」对应不同的报告模板,要哪个说哪个。写「对宁德时代(300750.SZ)做深度研究」,而不是「帮我看看宁德」。
- 点名产物。 要 Word 说「深度研究报告」,要 PPT 说「投委会 PPT」或「路演材料」,两个都要就明说。不点名时默认只输出文字分析,不会生成文件。
- 说清数据口径。 写一句「用插件数据源拉取最近四个季度的财务数据,标注来源与取数日期」就够,不用自己准备数据。
- PPT 要可编辑就明说。 写明「所有元素可编辑的 .pptx,不要图片贴片」,能避免个别任务退化成整页图片。
第 5 步:取回产物并核对
会话回到idle 后,通过产物接口取回交付物:
output/ 目录下:
- Word 深度研究报告(如
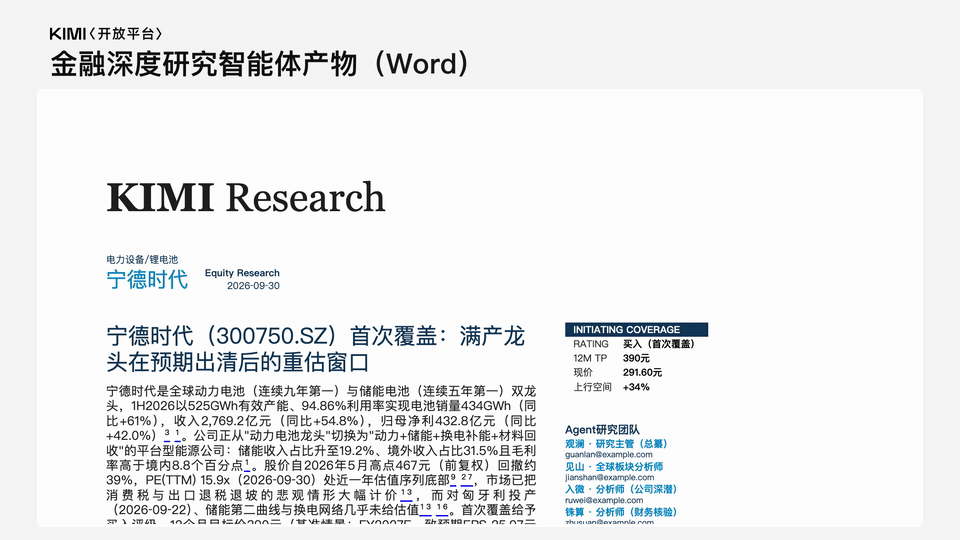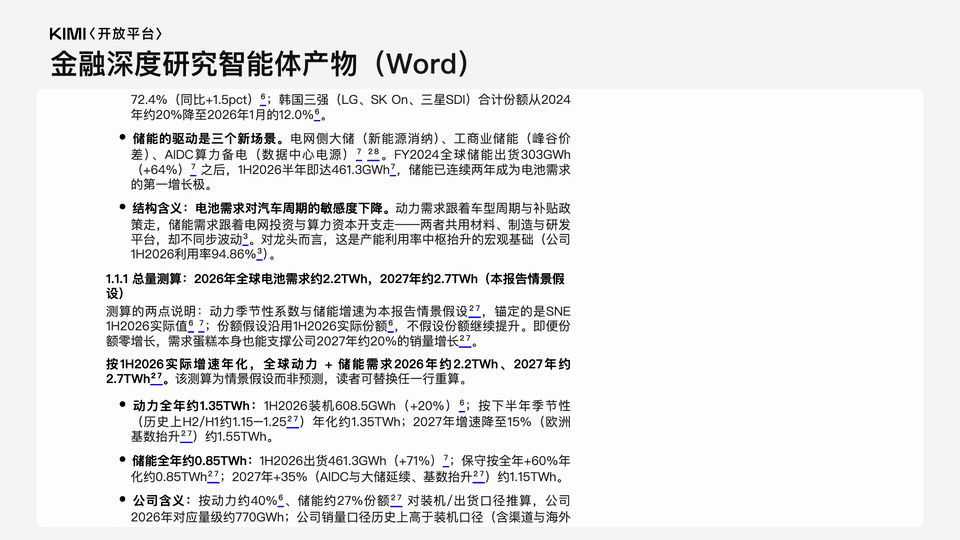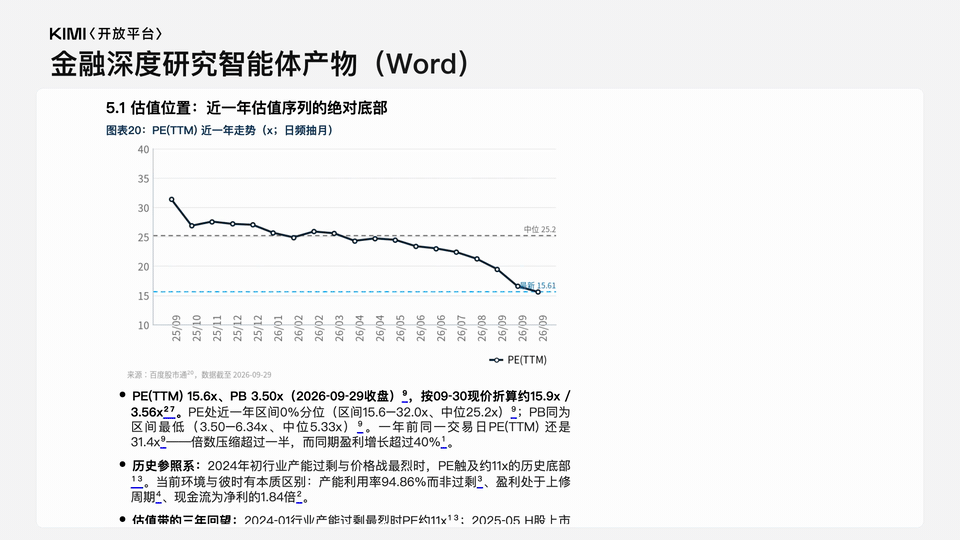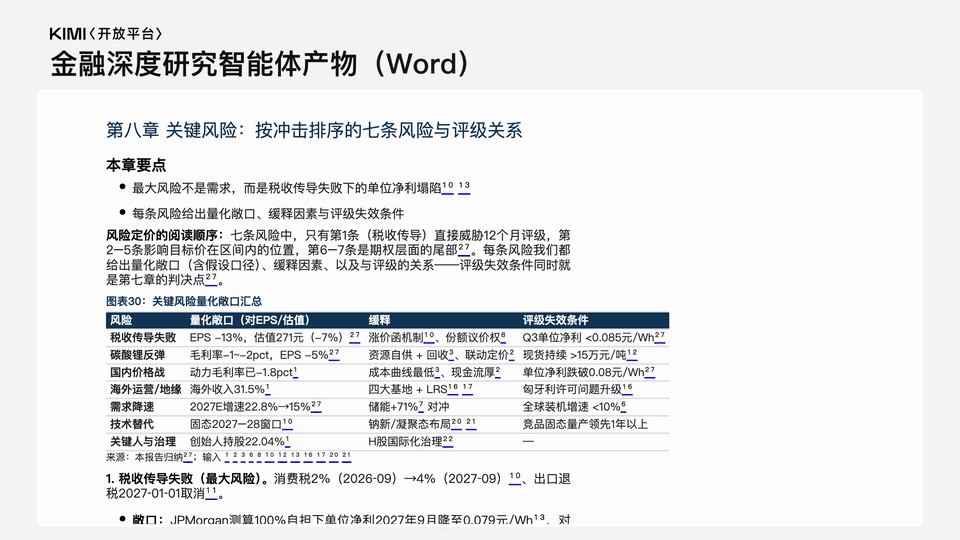
output/CATL_deep_dive.docx):几十页的完整报告,章节通常包括投资要点、公司分析(业务模式、竞争优势)、行业分析(趋势、格局、风险)、财务分析、估值(一致预期 × 自下而上倍数定价 + DCF 交叉验证)、投资论点与催化剂,末尾附来源表。所有数据标注来源和取数日期。报告篇幅取决于任务复杂度和上传材料规模,首次覆盖报告通常 30–45 页; - 投研 PPT(如
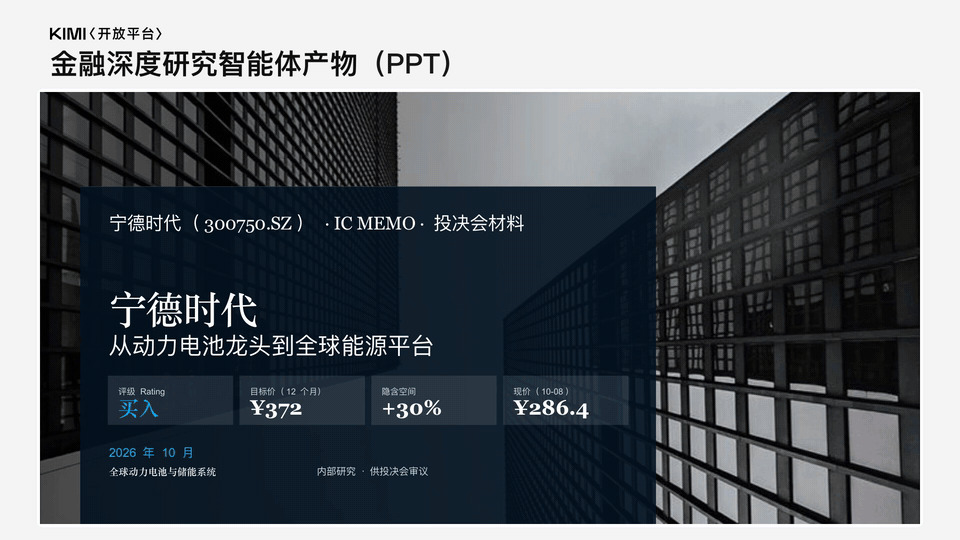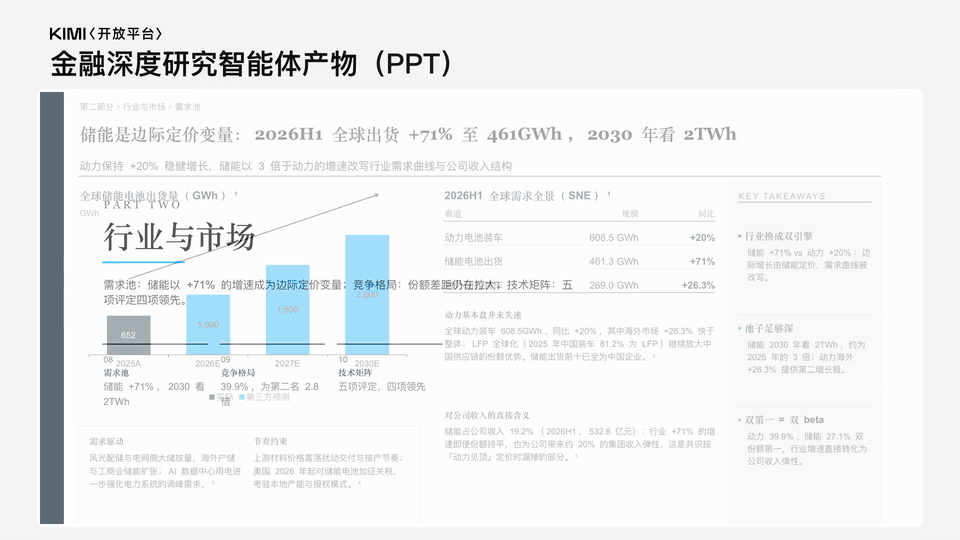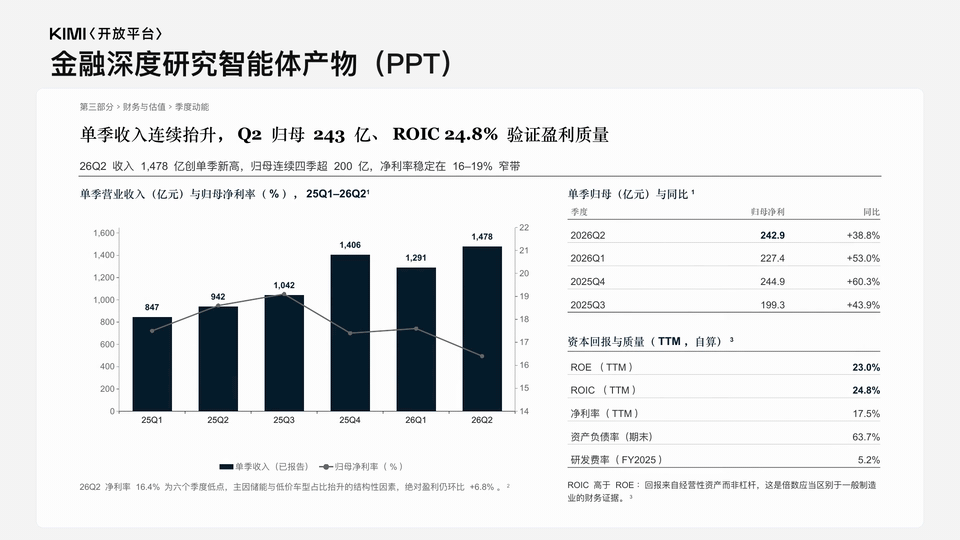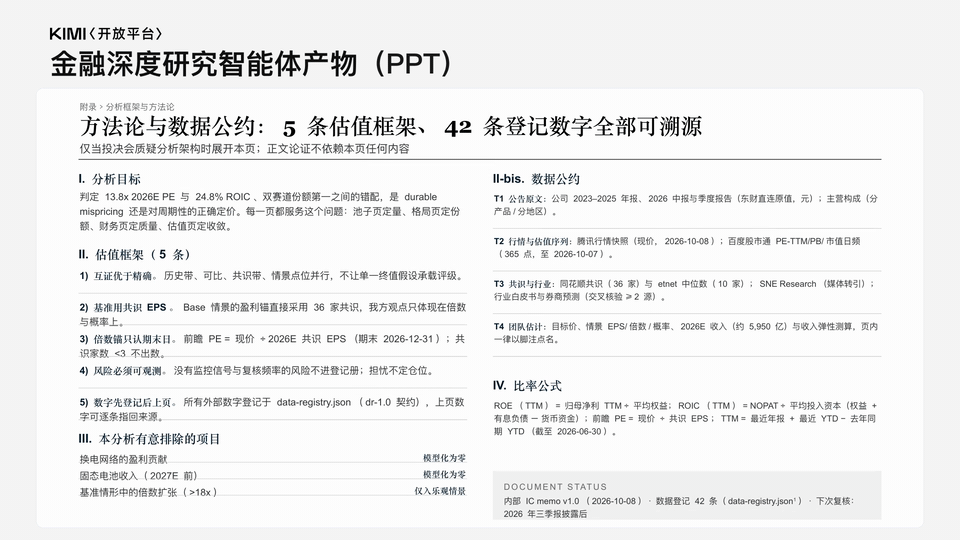
output/CATL_IC_deck.pptx):同一份研究的压缩版,20 页左右,麦肯锡 / 外资行风格,每页一个论点、标题即结论,图表是 PPT 原生 chart(可以在 Office / WPS 里直接改数据),不是截图。
运行与观察
深度研究是长任务,标准档报告通常要跑 1–1.5 小时,深度档 2–3 小时,建议在事件流里盯到结束。判断一次运行是否正常,看这几处:session.status:running表示开工,回到idle表示本轮完成,可以去取产物;agent.tool_use/agent.tool_result:能看到智能体调了哪些数据插件、读了哪些文件。研究阶段应该看到数据插件的调用,产出阶段应该看到文件写入;如果产出阶段还在大量取数,说明「先研究后产出」的约定没生效;session.error:任务失败时出现,携带错误类型与信息。
事件流断连时用最后一帧 SSE 消息的
id: 字段作为 cursor 续读,详见 事件流。
可扩展方向
- 批量研究:多个标的可以在同一会话里一起下达,产出统一落在该会话的
output/目录;需要会话级隔离时建多会话并发跑; - 多智能体拆分:先跑通单智能体长链路,再按「取数 / 研究 / 产出」拆成多个专职智能体,委派配置写在
multiagent字段里,详见 多智能体编排; - 定期跟踪:首覆报告发出后的定期跟踪(季报点评、周报)是周期性任务,用 触发器 按计划自动运行;
- 嵌入自有系统:把会话创建、事件流订阅、产物取回接进自己的投研平台,人工审核放在你的业务系统里,确认无误再对外发布。
下一步
使用金融研究插件
插件的引用方式、版本固定与凭据注入。
上传研究材料
上传原始材料、挂载会话与取回产出文件。
配置定期跟踪
用触发器把季报点评、周报做成定期跟踪。