

Agent 架构总览
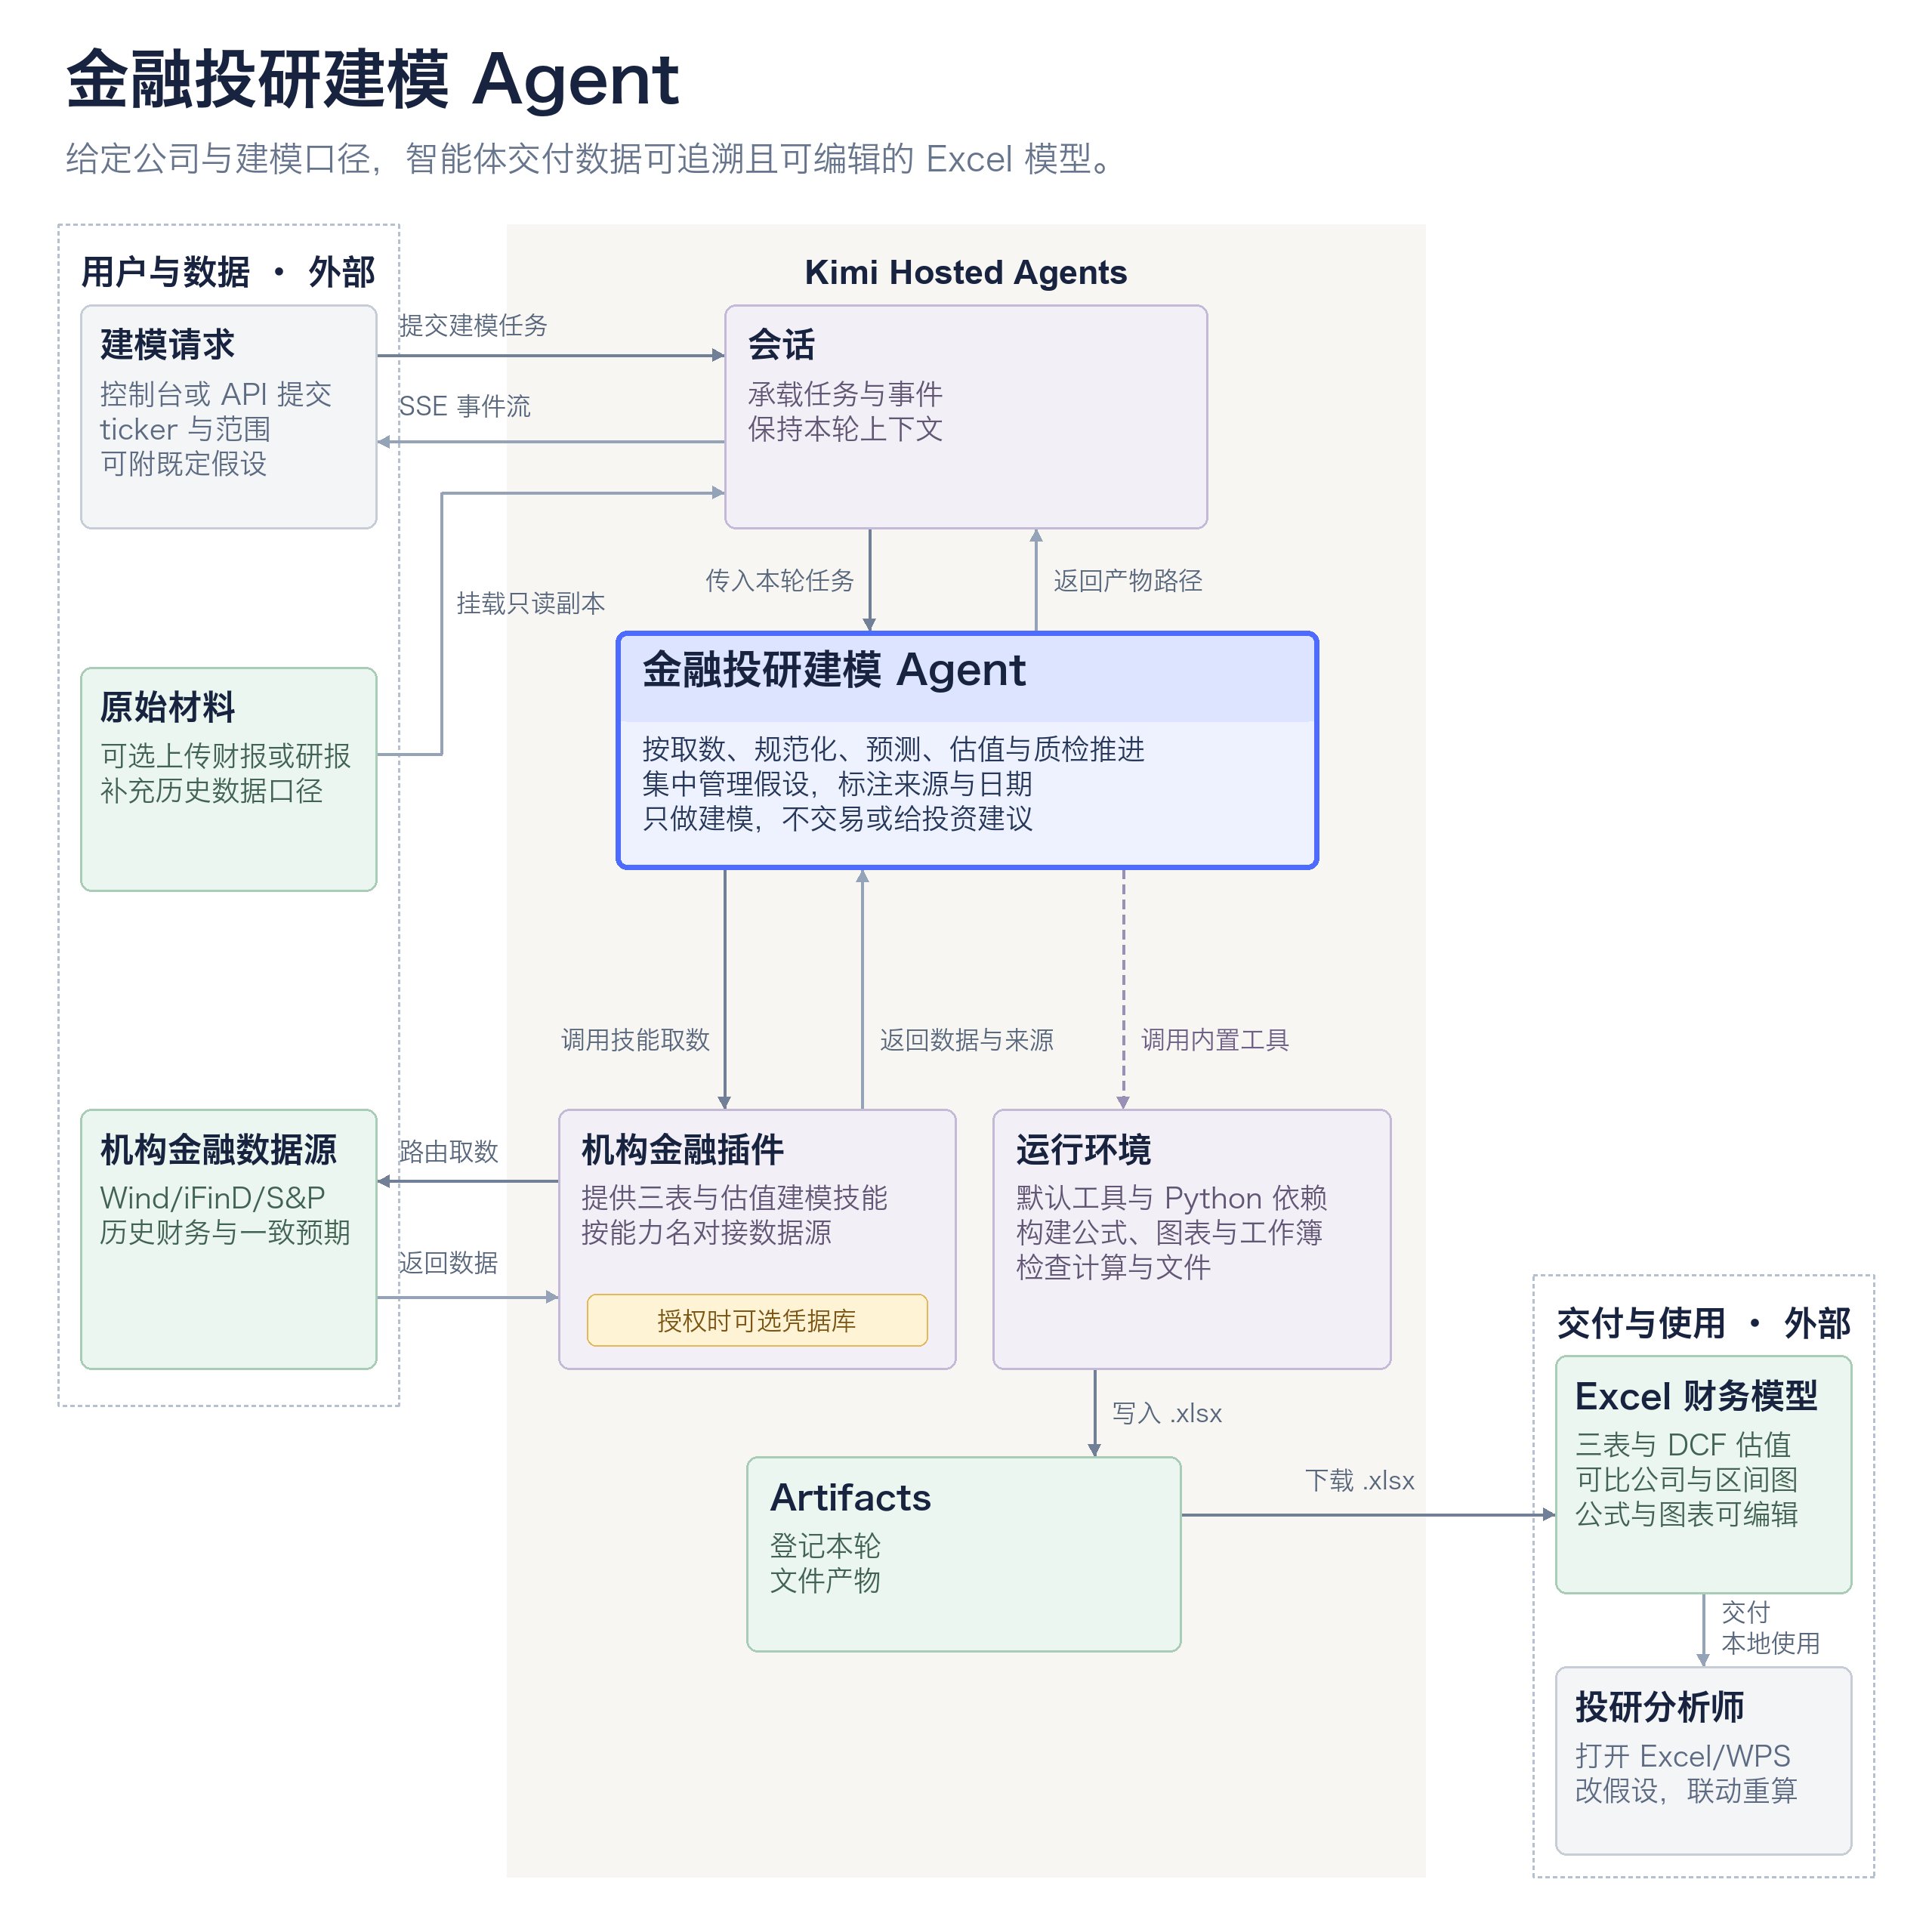
- 调用方创建会话并提交任务,明确标的代码、模型范围和已有假设;如有财报原文,可先上传并挂载;
- 智能体通过机构金融插件的数据源路由获取历史财务、市场一致预期和可比公司行情等数据,并为每个关键输入标注来源和取数日期;
- 数据齐备后开始构建模型,依次完成报表规范化、盈利预测和估值建模,并将全部假设集中写入 Assumptions 工作表;
- 在沙箱中使用 openpyxl 构建
.xlsx工作簿,写入公式、创建图表并设置格式。图表引用计算单元格,而非静态图片; - 执行质检,检查表间勾稽关系,例如净利润计入留存收益、现金变动与货币资金一致;无法获取的数据在
Data_Sources表中注明原因; - 将成品写入
output/目录并登记为产物。调用方下载后,可使用 Excel 或 WPS 继续编辑。
建模流程具有严格的先后顺序,数据获取完成后才能进入预测和估值,因此采用单智能体,以减少多智能体协调成本。插件负责提供建模方法和数据源接入,智能体按照固定流程执行建模任务。
核心设计
官方金融财务建模智能体由模型、系统提示词、机构金融插件和默认内置工具集组成,设计重点包括以下三方面:- 可编辑的 Excel 产出:公式可追踪,图表引用计算单元格,假设集中管理且可修改,而不是静态截图;
- 关键输入可溯源:标注数据源和取数日期,无法获取的数据在
Data_Sources表中注明原因,严禁编造,缺失数据不得按零处理; - 固定的执行顺序:按照取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检的顺序执行,不得跳步。
系统提示词:固定建模工作流
建模中的常见问题包括执行顺序错误、假设依据不足和来源缺失。系统提示词通过明确工作流顺序和数据规范,减少这些问题:- 固定流程:收到建模请求后,严格按照「取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检」的顺序执行,不得跳步;数据获取完成后才能开始建模;
- 数据规范:所有数据均通过插件的数据源路由获取,每个关键输入标注来源和取数日期;无法获取的数据在
Data_Sources表中注明原因,严禁编造;缺失数据不得按零处理,除非明确声明相应假设; - 假设管理:WACC、永续增长率、预测期收入增速等假设集中记录在 Excel 的 Assumptions 工作表中,模型公式引用对应单元格,修改假设后全模型联动重算;
- 任务边界:仅用于财务建模,不执行任何交易,不提供投资建议;事实、计算和推断分别呈现;
- 输出规则:成品写入
output/目录,最终回复使用相对路径列出文件(如output/CATL_model.xlsx),客户端按约定取回。
插件:提供建模方法和数据源接入
机构金融插件(institutional-finance-kit)提供建模所需的方法和数据源接入,包括两部分:
- 建模技能:插件中的
institutional-financial-modeling技能定义了三表、DCF 与可比公司估值的完整工作流,包括工作表结构、公式设计和敏感性分析方法,为生成完整的财务模型提供规范; - 数据源路由:插件统一对接 Wind、同花顺 iFinD、S&P 等数据源。智能体通过「能力名」请求数据(如历史财务、市场一致预期),无需直接处理各供应商的接口差异。
工具:使用默认内置工具集
平台默认内置工具集提供文件读写、代码运行和联网检索能力,可直接使用。构建 Excel 时,通过代码运行工具(ipython)在沙箱中调用 openpyxl。插件已覆盖数据获取需求,通常无需额外接入 MCP 服务;如需接入,参见 接入 MCP。配置选择
本案例选择kimi-k3。建模需要同时处理长财报原文、技能规范和大量结构化计算,对长上下文和指令遵循能力要求较高;多轮搭建过程中上下文持续增长,kimi-k3 的长上下文能力和缓存计价有助于控制成本,详见下文「运行成本」。
各项资源的配置如下:
运行成本
在不计插件调用费用的情况下,建模成本主要来自模型 tokens。沙箱按运行时长计费,价格为 ¥0.072 / 小时;一次建模约需 45–90 分钟,费用约 ¥0.1。文件上传与抽取限时免费,详见 托管智能体定价。按kimi-k3 的 公开单价估算,一次完整建模约需 ¥30–50,耗时 45–90 分钟。
上述估算基于 2026 年 9 月底至 10 月初的若干次生产会话,仅供参考,实际费用以控制台账单为准。费用和耗时会随标的数据量、财报篇幅、上传材料情况以及取数和返工轮次显著变化。数据完整的大型公司与数据较少的新上市标的之间,成本可能相差数倍。上传券商研报、内部研究等材料有助于提高历史数据口径的准确性并减少取数轮次,因此也可能降低成本、缩短耗时(见下文「第 3 步:准备原始材料」)。
一次完整建模需要多轮模型调用,每轮都会携带累积的上下文,累计输入可达上千万 tokens,其中约 95% 为重复前缀。命中上下文缓存后,这部分输入按缓存命中价计费,是控制成本的关键;如果同等输入量全部按未命中价计费,成本约为当前的六至七倍。输出主要为 openpyxl 构建代码和最终回复。插件调用按次数另行计费,不同插件分档定价,详见 托管智能体定价;上述估算不含插件费用。
建模质量在很大程度上取决于输入材料。平台无法直接提供受版权和合规限制的券商研报、私有数据、内部研究和历史财务原文,需要你自行准备并上传,或接入私有信息源(见下文「第 3 步」)。充分的材料有助于提高历史数据口径的准确性、为假设提供依据并减少取数轮次。
从最小版本开始搭建
最小配置为「单智能体 + 机构金融插件」。插件已包含建模技能和数据源接入,完成配置后即可运行。具体步骤如下:第 1 步:创建智能体
以下是一个可运行的创建命令。该示例并非官方配置的逐字拷贝,当前官方配置以GET /v1/agents 的返回结果为准:
id 作为 AGENT_ID。通过 GET /v1/plugins 查询插件 ID,并按显示名「机构金融插件」查找,或在控制台智能体表单中直接勾选。可根据需求调整以下字段:
第 2 步:创建执行环境
建模需要 openpyxl、numpy、matplotlib 等 Python 库来构建 Excel 和图表。创建云沙箱环境时,在config 中声明 pip 依赖;如果数据源通过内网网关访问,请将对应域名加入网络白名单,详见 执行环境。从响应中保存 id 作为 ENVIRONMENT_ID。
第 3 步:准备原始材料(建议尽可能提供)
建议尽可能提供券商研报、私有数据、内部研究和历史财务原文等材料。与仅依靠插件检索相比,使用原始材料有助于提高历史数据口径的准确性和假设的可靠性。提供方式有两种:- 直接上传 PDF:通过
POST /v1/files上传研报、财报和内部材料并获取file_id;创建会话时将其添加到resources。文件会以只读副本形式挂载到沙箱的/mnt/agents/upload/目录,详见 文件; - 通过 MCP 和凭据库接入私有信息源:如果机构已有数据服务(Wind、内部研报库、私有数据库),可将其封装为 MCP 服务并接入智能体。将凭据保存在 凭据库,创建会话时把凭据库添加到
resources(绑定仅在创建时生效),运行时自动注入。数据授权关系由机构与数据供应商自行约定,平台不接触相关数据。详见 接入 MCP。
第 4 步:创建会话并提交任务
快速开始 已介绍完整调用流程,此处仅展示建模任务的特有部分。创建会话:id 作为 SESSION_ID,订阅事件流(见 快速开始),然后提交任务:
- 提供证券代码。 先明确市场(A 股 / 港股 / 美股)和标的,并提供证券代码以避免同名歧义。例如,使用「宁德时代(300750.SZ)」,而不是「帮我看看宁德」。
- 明确模型范围。 默认产出包括三表、DCF、Peer Comps 和 Football Field;如果只需要部分内容,请明确说明,例如「只要三表和 DCF,不要可比公司」。如需情景分析(乐观 / 中性 / 悲观),也应在任务中注明。
- 提供已有假设和原始材料。 如有既定假设(例如公司指引中的收入增速、投资委员会确定的 WACC 区间),请直接写入任务,智能体会将其填入 Assumptions 表,而非使用默认值。也应尽可能提供财报原文、券商研报和内部研究(见上文「第 3 步」),以提高历史数据口径的准确性和假设的可靠性。
第 5 步:取回产物
会话状态变为idle 后,先列出该会话的产物,找到 Excel 文件对应的产物 id:
GET /v1/sessions/$SESSION_ID/filesystem 浏览会话文件系统,详见 文件。
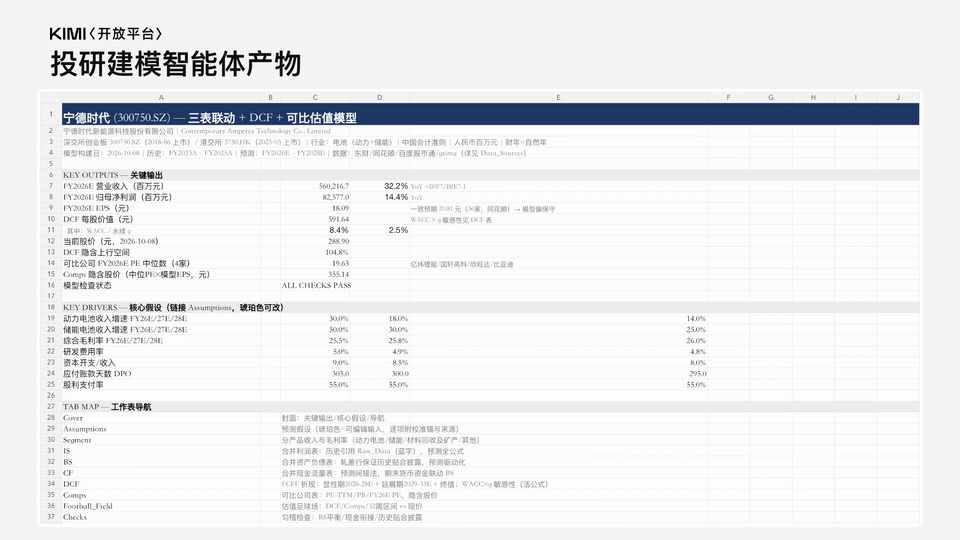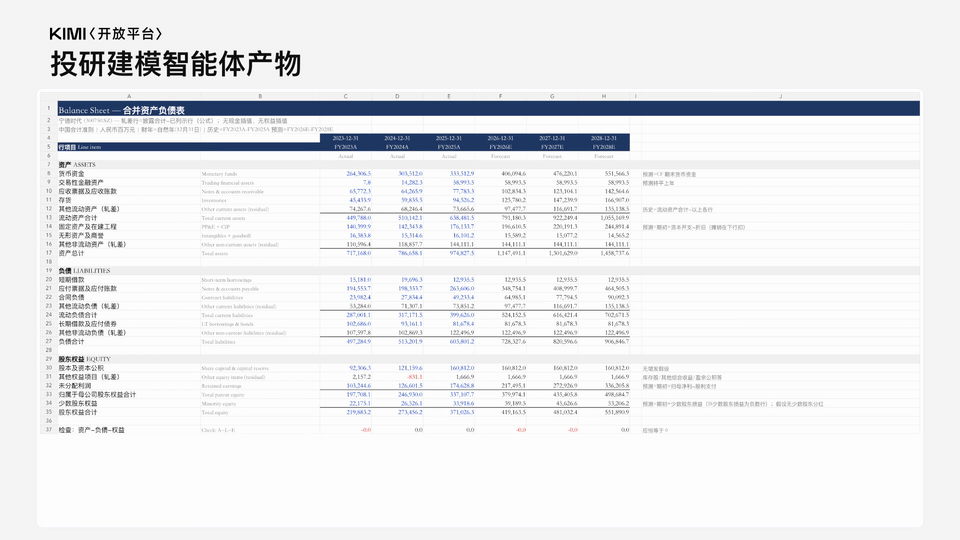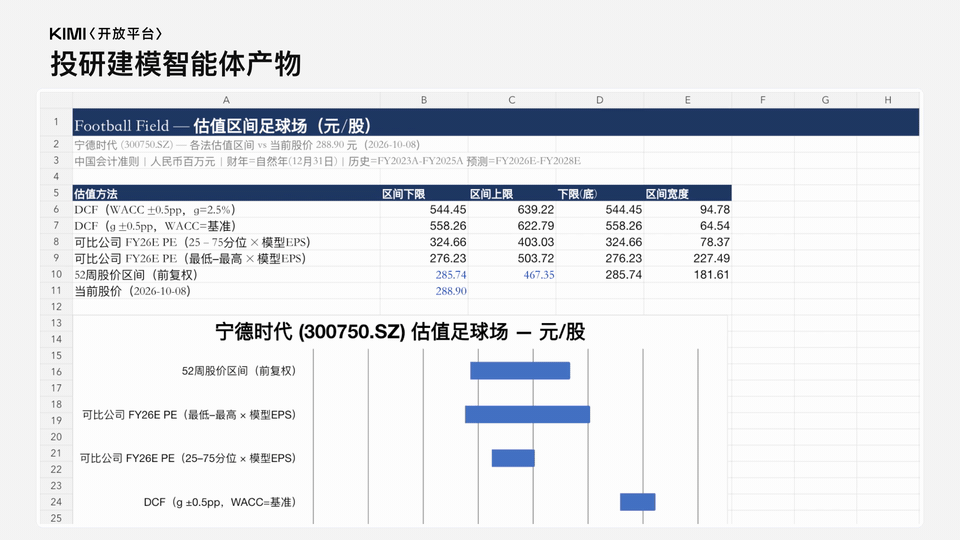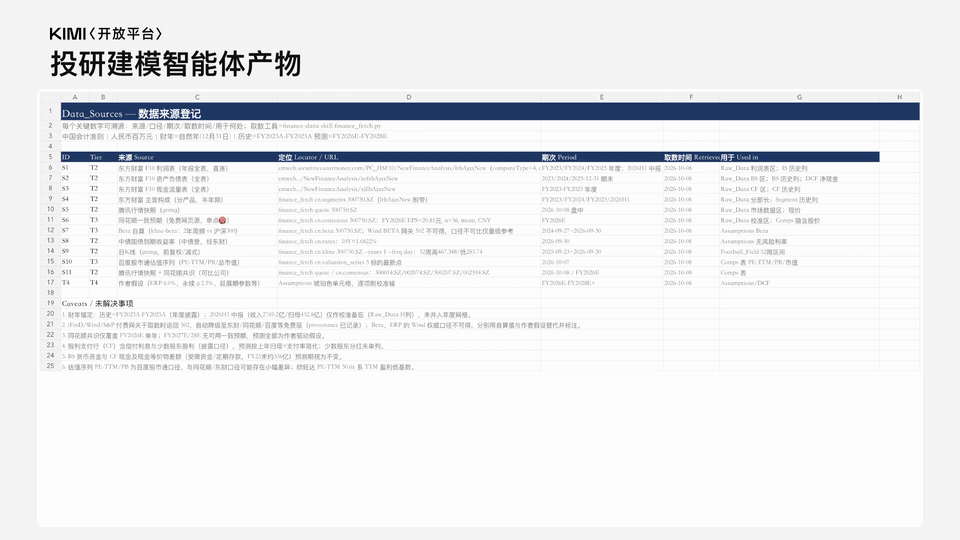
产物为 .xlsx 工作簿,可使用 Excel 或 WPS 打开并编辑,包含以下工作表:
- Assumptions:集中记录全部假设,包括 WACC、永续增长率、预测期收入增速和利润率假设。其他工作表的公式引用此表单元格,修改假设后,全模型联动重算;
- 三表:包括资产负债表、利润表和现金流量表,涵盖历史三年规范化数据、未来三年预测及五年 DCF 延展期;表间勾稽关系包括利润表净利润计入资产负债表留存收益,以及现金流量表现金变动与资产负债表货币资金一致;
- DCF:包括自由现金流预测、折现、终值,以及企业价值至股权价值的桥接计算,并附 WACC × 永续增长率的敏感性矩阵;
- Peer Comps:同行业可比公司的估值对比表,包含 PE-TTM、PB、前瞻 PE 等指标,数据来自插件的数据源路由;
- Football Field:对比不同估值方法(DCF、可比公司、历史区间)的估值范围,图表引用计算单元格,而非静态图片;
- Checks:包含资产负债表平衡、现金流与资产负债表衔接、收入衔接等检查,逐期列出差额和 PASS / REFERENCE 状态,便于核对模型是否配平。
Data_Sources 表逐条登记,包括来源、定位、期次、取数时间和使用位置。无法获取的数据也在该表中注明原因。文件保存在会话的 output/ 目录,可通过产物接口下载并继续编辑。
运行监控
取数和建模通常需要 45 分钟至 1.5 小时;需要重试时,耗时可能更长。建议通过事件流持续查看运行状态,直至任务完成。可以通过以下字段判断运行是否正常:session.status:running表示正在运行,变为idle表示本轮完成,可以下载产物;agent.tool_use:可查看每次数据获取使用的数据源和口径;数据异常时,可优先检查此项;session.error:任务失败时出现,包含错误类型和信息。
id: 字段作为 cursor 重新订阅即可续读,详见 事件流。
建模场景还需关注以下事项:
可扩展方向
- 批量建模:为每个标的分别创建会话并并发执行,按会话取回结果,避免相互影响;
- 嵌入自有系统:将托管智能体 API 集成到自有投研平台,由业务系统创建会话、订阅事件流并取回 Excel,分析师可在自有界面中获取并继续编辑模型;
- 多智能体拆分:将取数、建模和质检拆分为专职子智能体,并在
multiagent字段中配置委派,详见 多智能体编排。建议先验证单智能体与插件的组合,再评估是否拆分。
下一步
使用机构金融建模插件
插件的引用方式、版本固定与数据源路由。
上传财报与研究材料
上传财报材料、挂载会话与取回 Excel 产物。
配置 Excel 构建依赖
云沙箱的 pip 依赖声明与网络白名单。