

Agent 架构总览
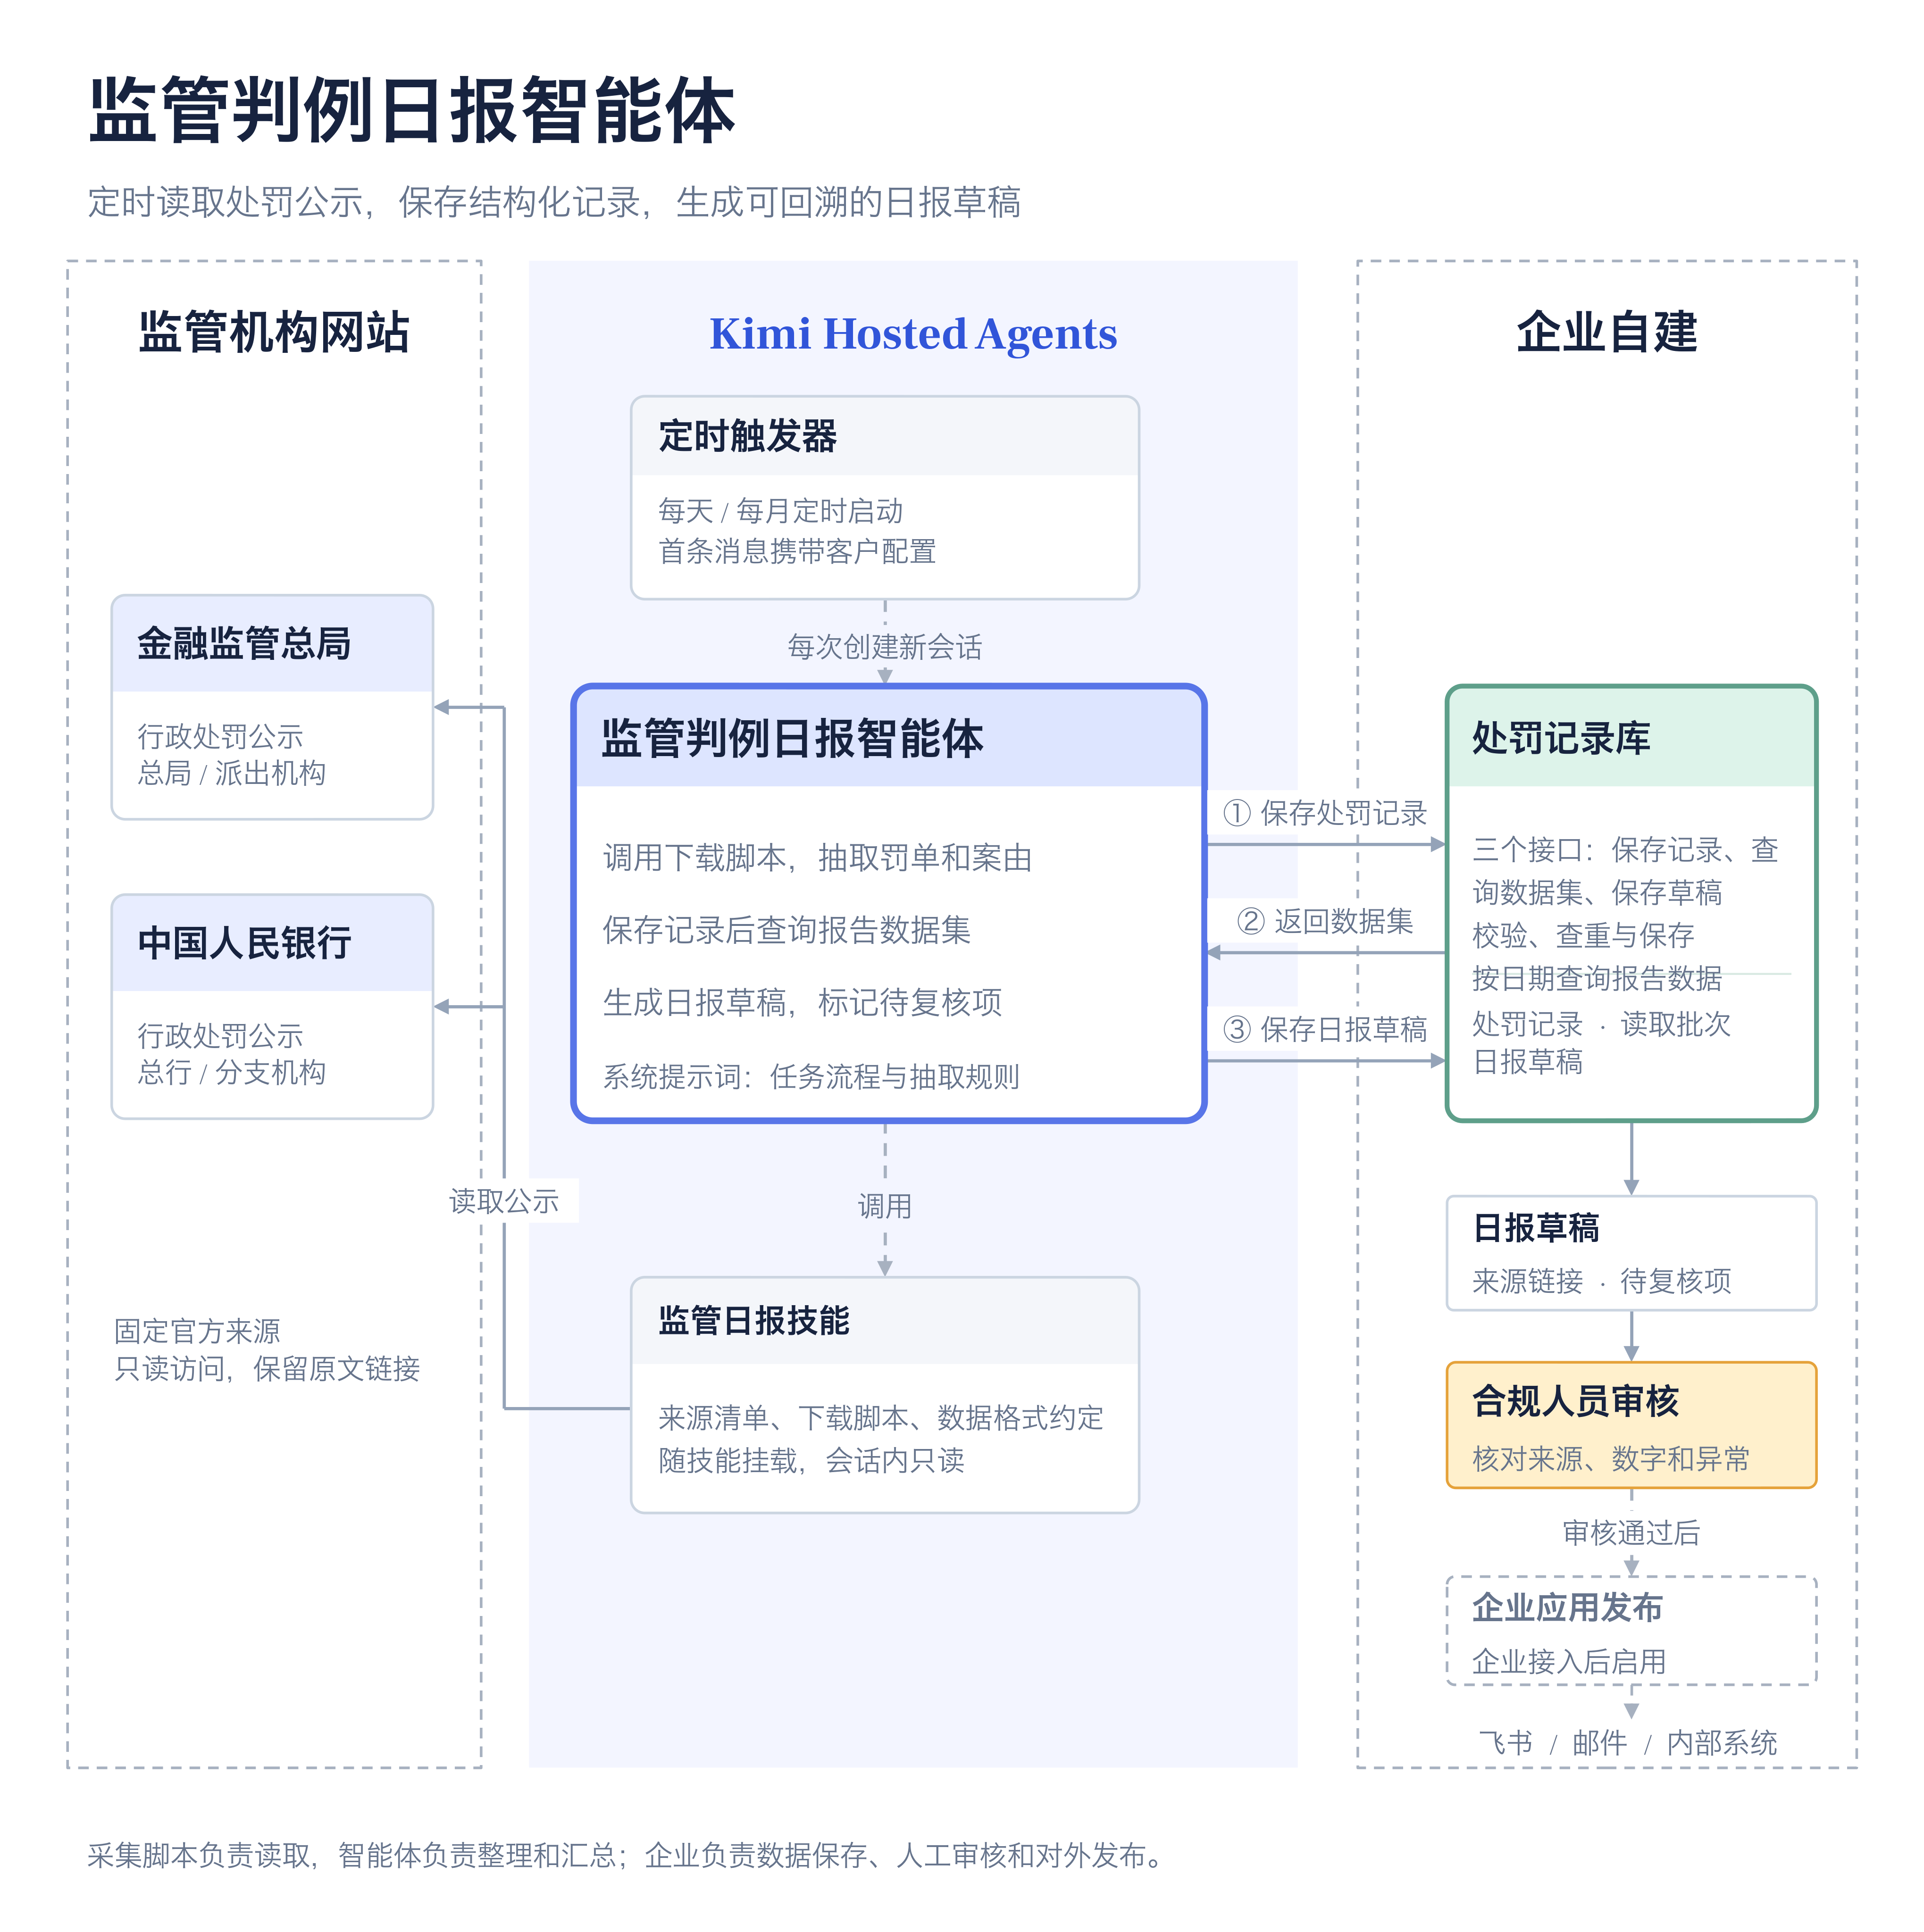
- 监管机构网站:本案例以金融监管总局和中国人民银行的行政处罚公示为核心来源。智能体只读取公开页面,不登录、不提交表单。
- Kimi 托管智能体:平台托管智能体、会话和每日定时任务。智能体用技能中的下载脚本获取新增内容,按统一字段抽取罚单和案由,调用处罚记录库接口保存记录,再查询当天数据生成日报草稿。
- 企业自建服务:企业提供一个轻量的处罚记录库,负责校验、查重、保存罚单、查询报告数据集和保存日报草稿。本文只定义记录库的接口和业务规则,企业接入时实现为自定义工具,接已有数据库或业务服务。
- 定时启动:Kimi 托管智能体的触发器每天早上创建一个新会话。
- 读取来源:下载脚本逐一读取来源清单中的网站,找到新增的列表、详情页或公示文件。
- 结构化抽取:智能体把不同页面形态统一整理为文号、当事人、案由、处罚内容、金额、机关、日期和来源链接。
- 保存和查重:处罚记录库按来源和文号保存记录,重复文号更新已有记录,保存时完成机构类型、省份和职能领域分类。缺文号的记录用机关、公示日期和当事人拼成查重键,照常保存。
- 生成日报:智能体查询统计日期范围的数据集,按固定口径生成 Markdown 草稿。
- 人工审核:合规人员核对来源、数字和异常记录,再决定是否发布。
核心设计
各层职责分工
智能体的行为由三处定义:- 共享内容进入技能和提示词,私有要求进触发器首条消息:来源清单和格式约定很少变化,任务配置可能经常调整。
先落库处罚记录,再生成日报
从官方公示到草稿经过四步:
罚单记录是事实,日报是派生产物。先进行事实落库意味着:
- 同一罚单按文号查重,不会重复统计;
- 统计口径变化后可以从记录重新计算,不必重读网站;
- 日报中的每个数字都能回到具体记录和原文链接。
智能体和脚本的分工
脚本负责下载页面和公示文件、校验响应、控制分页。固定来源每天用固定脚本执行而不依赖模型当场判断,可以保证行为可复现、失败原因可定位。 智能体基于下载结果做语义工作:理解行列关系,拆分罚单,按统一字段抽取处罚内容和案由。 智能体直接读网页是遇到新来源时的探测手段:先让智能体直接读取入口,判断是列表、JSON、DOC 还是 HTML 表格,验证入口有效、格式可解析。探测时智能体可以用沙箱内置的网页读取工具,也可以调用 Kimi API 的 Web Fetch 接口;如果来源封禁平台共享出口(例如返回 403 错误页),按「来源网站封禁共享出口时配置按域代理」一节配置代理,改用在会话内下载的方式探测。验证稳定后,把读取方式固化成脚本和测试,以技能形式挂载,并添加来源进入主流程。配置选择
模型选kimi-k3。智能体需要理解不同监管网站的页面结构,抽取处罚字段并遵守固定的数据格式与报告口径。
各项资源的配置如下:
运行成本
按单次处理 2 个监管来源、32 条处罚公示记录估算。模型输入按缓存未命中价计算,输出按输出价格计算,均见kimi-k3 的 公开单价;沙箱按 托管智能体定价 的 ¥0.072 / 小时计算:
同样是这批工作量,人工下载、整理、查重和起草约需 3 小时,智能体约需 20 分钟,耗时减少约 89%。以上为估算,实际用量随公示页数、附件篇幅、上下文缓存命中情况和返工轮次变化,以控制台账单为准。处罚记录库、企业代理和日报发布系统由企业自建,其基础设施与运维成本不计入上述费用。
从最小版本开始搭建
1. 准备处罚公示来源清单
处罚公示来源清单当前包含两个核心来源。来源 ID 是自己起的短名,用于在配置和报告中引用来源:
智能体只按清单读取,不自行增减来源。清单随下载脚本打包进技能,在第 3 节创建智能体时一并挂载。
2. 准备处罚记录库
智能体只需要三个接口:- 校验:来源和批次标识必填,缺失整批拒收;文号和当事人同时缺失的单条记录拒收并进入复核;
- 查重和保存:按来源和文号查重,相同文号更新已有记录;缺文号的记录用回退键照常保存;
- 分类:保存时按规则填充机构类型、省份和职能领域,判不了归 unknown;个人罚单名称中没有单位的,按同批次机构罚单关联推断;
- 报告:相同报告不重复生成草稿,日报初始状态始终是草稿。
企业接入时,把这三个接口实现为自定义工具绑定到智能体,背后接现有数据库或业务服务;操作名和输入输出保持不变,智能体的提示词和调用方式不需要改。
3. 创建监管处罚日报智能体
系统提示词负责定义任务和边界,而不是写死每个网站的解析程序。示例如下:数据格式约定:统一字段
不同来源的页面形态不同,但智能体抽取和下载脚本都以同一组字段为目标;这组字段作为数据格式约定写入技能:4. 创建执行环境
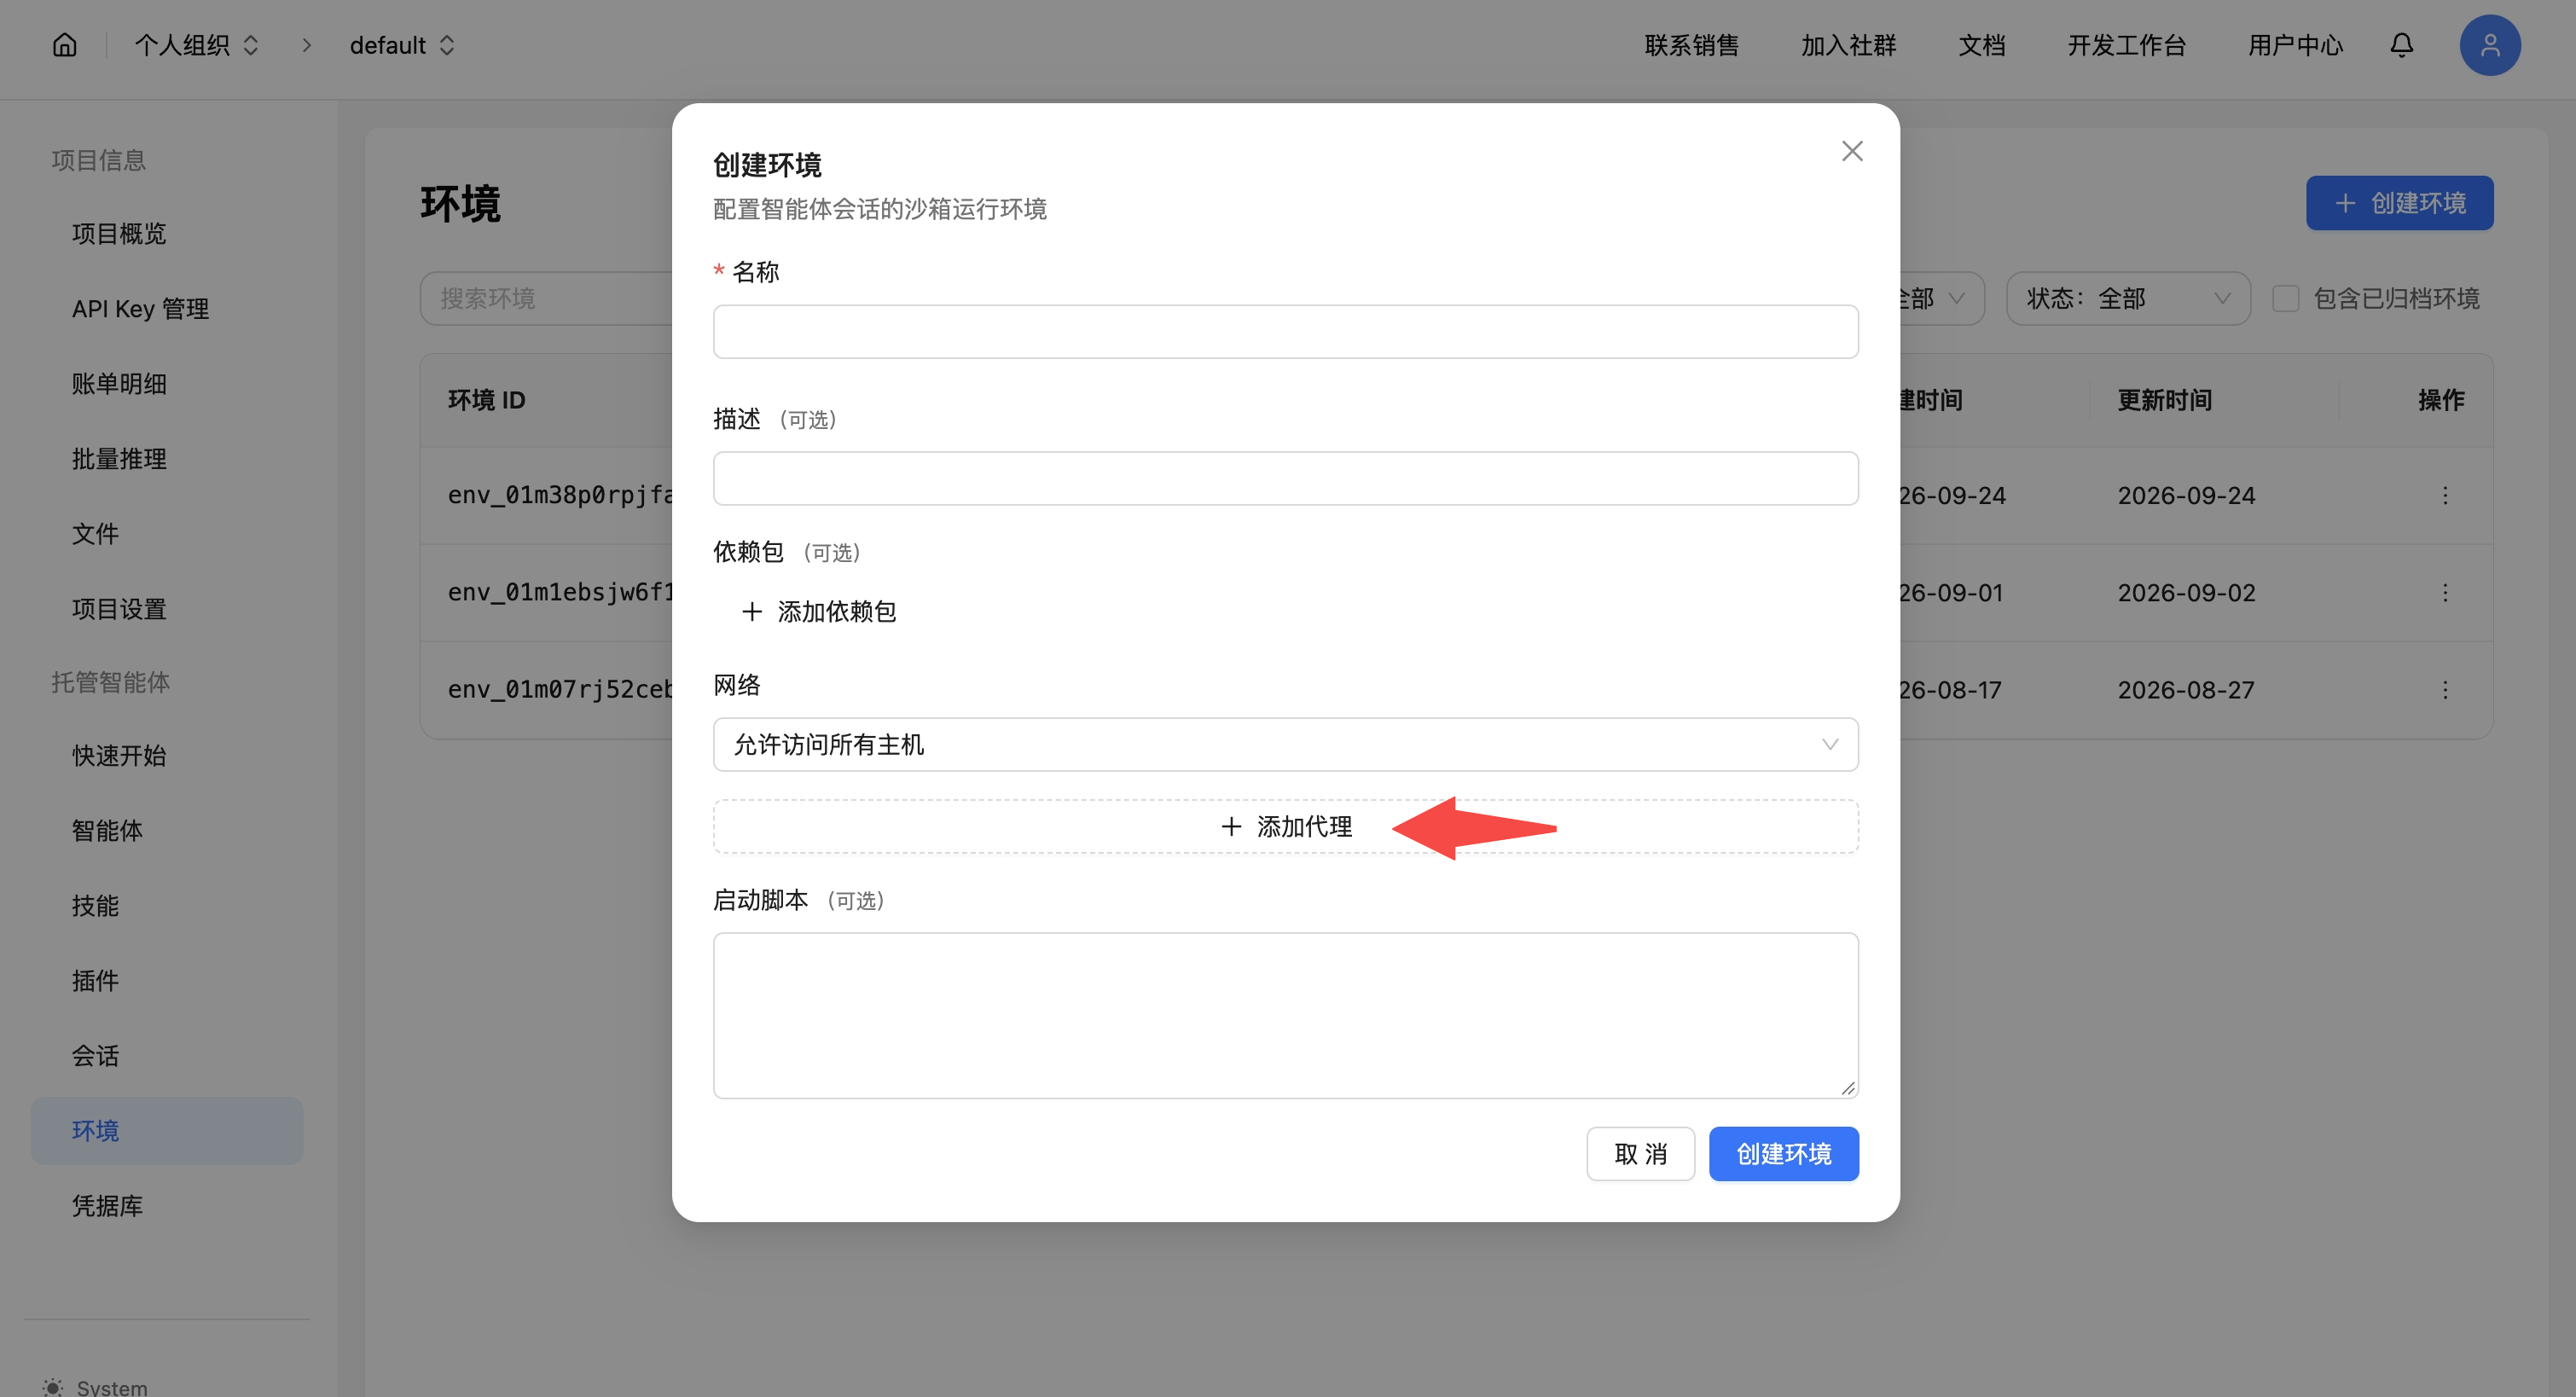
执行环境承载会话、脚本运行和工具调用。创建一个云端执行环境即可:来源网站封禁共享出口时配置按域代理
云端执行环境通过平台共享出口 IP 访问公网,个别监管网站会封禁这类 IP。 这种情况的标准解法是在执行环境中按域名配置自有代理(proxy):- 准备一个出口 IP 未被该网站封禁的 HTTP(S) 代理。目标网站封的是数据中心 IP,代理出口需要家庭或办公宽带这类普通 IP;
- 代理有认证时,先把凭据存入凭据库;
- 在执行环境的网络配置中添加代理,主机只填被封的域名,不要开启全局代理,其他来源继续直连;
- 保存后新建会话验证,旧会话仍使用旧配置。
5. 配置每日定时任务
使用 Kimi 托管智能体的触发器每天创建一个新会话,避免不同日期的任务上下文互相干扰。下面的示例每天 08:30 运行:resources 中绑定凭据库,供智能体访问处罚记录库。必需来源、统计时区和交付方式等任务参数写入 initial_events 的任务指令,不作为独立的资源类型挂载。技能管”能读什么”,配置管”这次必须读到什么”:处罚记录库看不到智能体挂的技能,只能拿配置里声明的必需来源对照实际收到的记录,缺来源就标记覆盖不完整。
日常运行使用新会话;跨天状态由处罚记录库保存,不依赖会话历史。触发器负责按时间启动任务,不负责读取网页、查重或审核报告。
需要月报时,再创建一个触发器,把 cron 表达式改为按月运行(例如每月 1 日 09:30),并在任务指令中把统计范围设为上一个完整自然月。月报和日报共用智能体、技能和处罚记录库,只有触发时间和统计范围不同。
6. 手动运行并检查结果
定时任务创建后,先手动运行一次:- 两个必需来源是否都被读取;
- 每条记录是否保留原文链接;
- 重复文号是否没有新增第二条记录;
- 缺文号的记录是否用回退键保存,并在报告脚注按机关和公示日期指代;
- 无法确定所在单位的个人罚单是否进入复核队列;
- 报告是否从已保存的数据集生成;
- 报告状态是否仍为草稿;
- 网站读取失败时,报告是否明确标记覆盖不完整。
7. 审核日报草稿
日报草稿包含:- 本次统计日期范围;
- 网站覆盖情况;
- 新增处罚记录;
- 处罚金额和处罚动作汇总;
- 大额处罚记录;
- 待复核项;
- 每条重点记录的原文链接。
接入企业系统
三个接口以自定义工具的形式绑定到智能体,底层实现可以替换为 SQLite、PostgreSQL、MongoDB 或企业已有数据平台。 主流程来源的下载脚本随技能维护;来源必须经过企业网关、代理或专用解析服务时,把下载封装为自定义工具。新来源先由智能体探测,验证稳定后再固化脚本,不需要为每个网站提前开发程序。下一步
配置每日定时运行
配置每日运行和查看运行记录。
配置处罚记录库工具
了解网页读取和自定义工具配置。
配置执行环境与代理
配置会话运行环境。
保存服务访问凭据
保存处罚记录库的访问凭据。